Cómo funciona la IA generativa: del entrenamiento a crear texto, imágenes y audio
Si ya has leído nuestra explicación sencilla de qué es la inteligencia artificial, sabes que la IA generativa es la que crea contenido nuevo: textos, imágenes, audio. Aquí vamos un paso más allá y abrimos el capó. ¿Qué ocurre antes de que escribas una petición? ¿Y qué pasa justo después de pulsar «enviar»?
La clave es separar dos momentos: el entrenamiento y la generación.
Primero Se Entrena
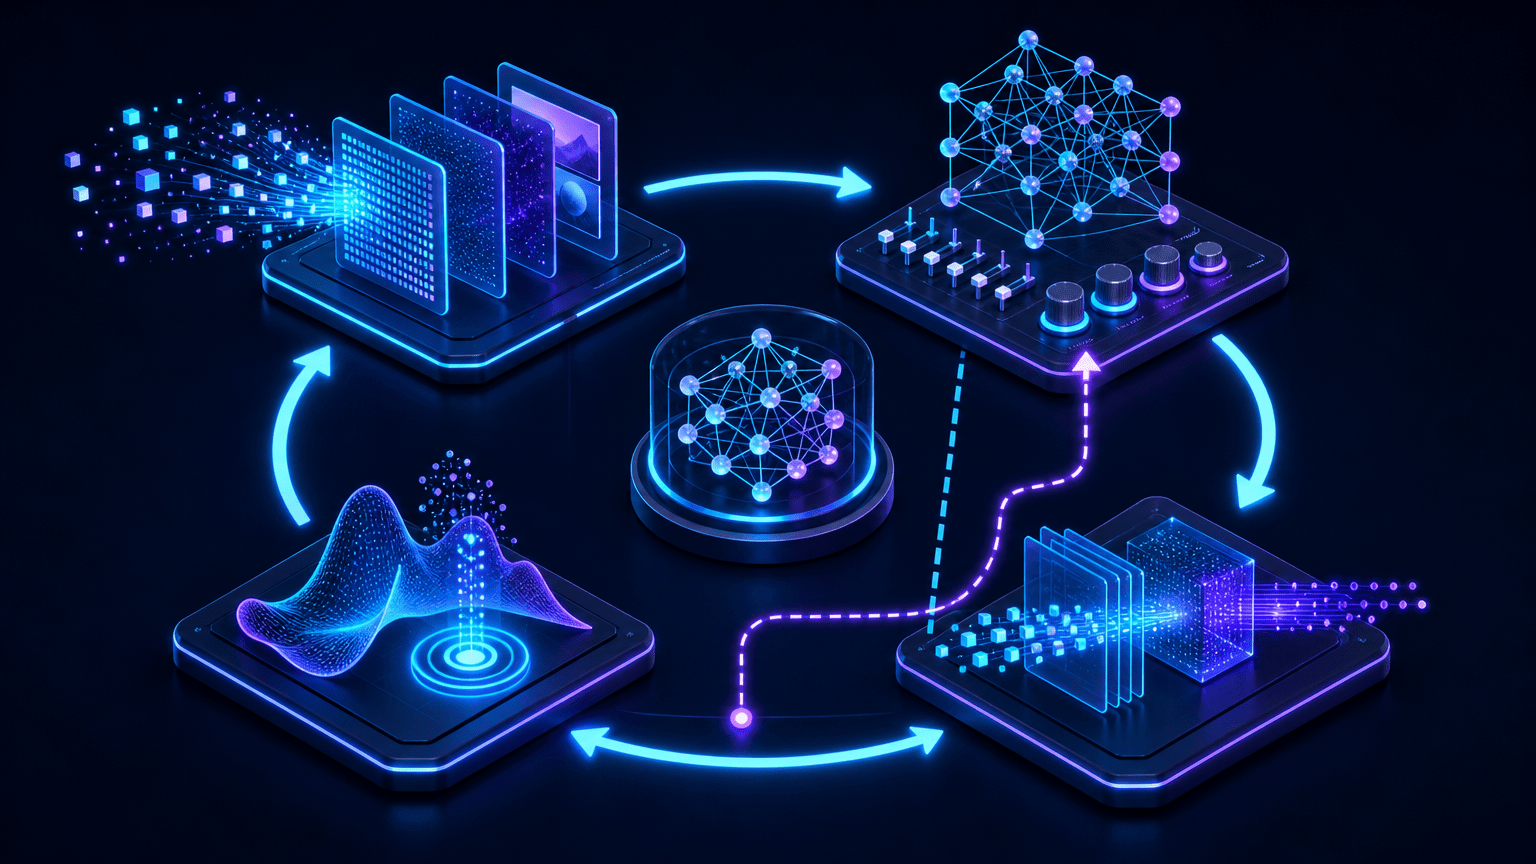
Un modelo de IA no nace sabiendo hacer nada. Durante el entrenamiento se le muestran muchísimos ejemplos y se van ajustando sus parámetros. En una red neuronal, esos parámetros incluyen los pesos y los sesgos. Si quieres entender qué son esas «neuronas» artificiales y en qué se parecen (y en qué no) a las biológicas, lo contamos en neuronas reales y artificiales. Y si te lías con la sopa de términos IA, machine learning y deep learning, tienes la guía de diferencias.
El ajuste funciona como un bucle. El modelo intenta producir una salida y se mide cuánto se aleja del objetivo. Esa medida se llama pérdida. Después, un método de optimización, como el descenso de gradiente, usa gradientes para decidir cómo retocar los parámetros y que el error sea algo menor la próxima vez. Esto se repite una y otra vez. Es parecido a practicar para un examen, pero con una cantidad de ejercicios que ningún estudiante soportaría ni con todo el café del mundo.
Estos términos (entrenamiento, pérdida, pesos, inferencia) aparecen en el Glosario de Machine Learning de Google, una buena referencia si quieres ver las definiciones técnicas.
Qué Aprende Un Modelo (Y Qué No)
Cuando decimos que un modelo «aprende», usamos una abreviatura cómoda. Lo que ocurre es que sus parámetros se ajustan hasta capturar regularidades estadísticas de los datos de entrenamiento: qué suele ir con qué, qué patrones se repiten, qué relaciones aparecen.
Lo que no hay dentro es un archivador con respuestas listas para copiar. Y si lo hubiera, sería el archivador más desordenado de la historia. Tampoco hay que imaginar que el modelo «comprende» como una persona, ni que siempre recupera una fuente concreta. «Aprende» no significa experiencia consciente ni intención.
Después Se Genera: La Inferencia
Cuando usas un modelo ya entrenado, estás en la fase de generación, también llamada inferencia. Le das una entrada (una pregunta, una descripción, un audio de referencia) y calcula una salida aplicando los patrones que ya tiene. Usarlo no implica, por sí mismo, modificar sus pesos. El modelo no se reentrena cada vez que le escribes.
Una forma de verlo: el entrenamiento es la larga preparación en el taller, y la inferencia es cada vez que se usa la herramienta con un encargo nuevo.
Texto: Modelos De Lenguaje Y Tokens
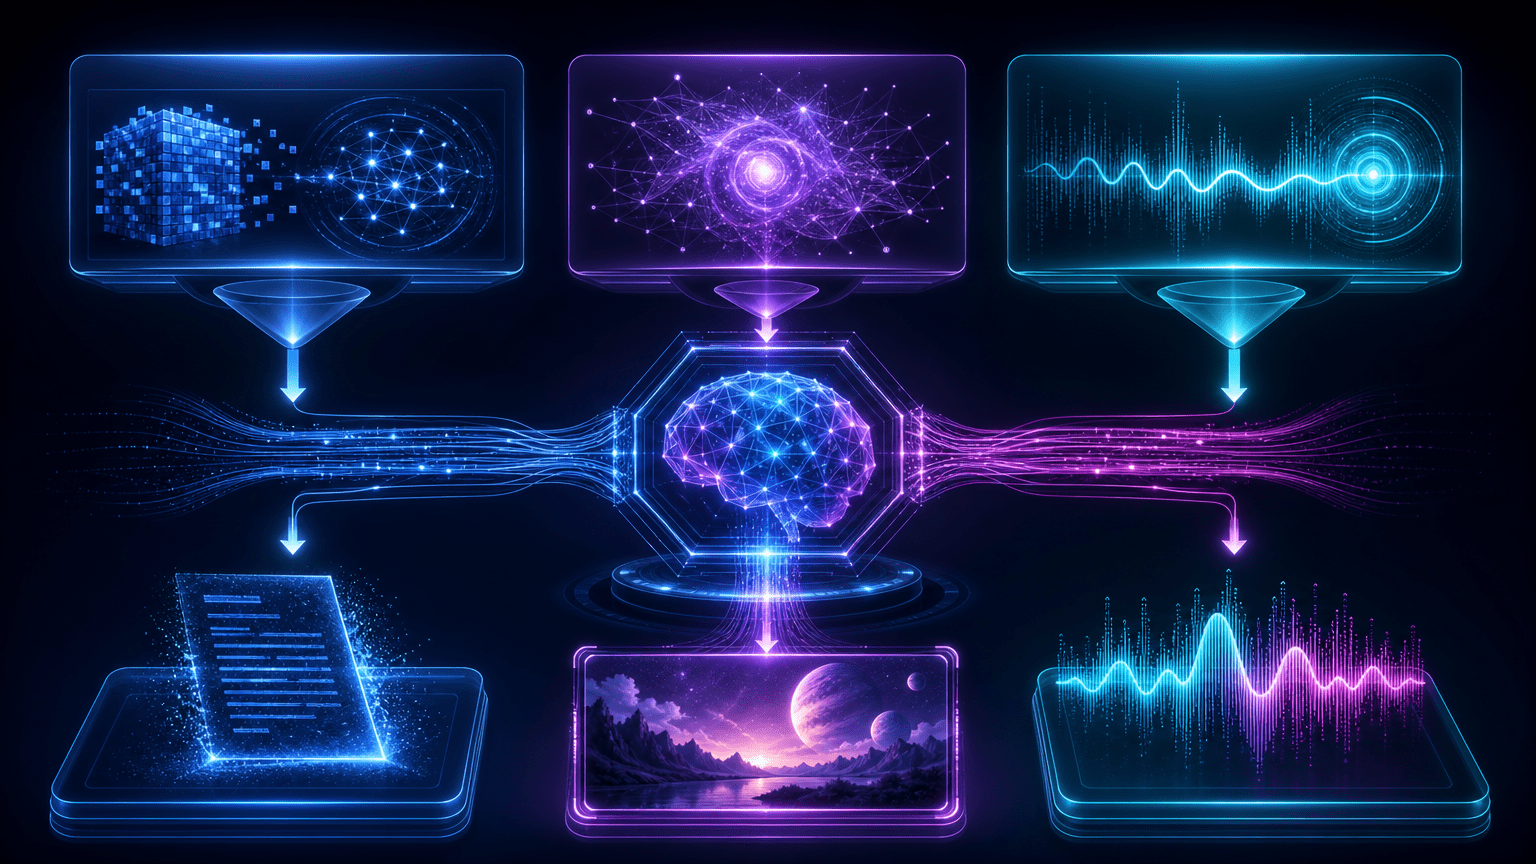
Un modelo de lenguaje trabaja con tokens, unidades de texto que pueden ser palabras completas, trozos de palabra o signos. Durante el entrenamiento, suele aprender a predecir piezas de texto a partir del contexto que las rodea.
Al generar, el proceso es paso a paso. Ante tu instrucción, el modelo calcula una distribución de probabilidad sobre las posibles continuaciones y elige una según su configuración de generación. Esa elección se añade al contexto, y el contexto influye en el siguiente paso. Así se va construyendo la respuesta, token a token.
Es lo que hay detrás de tareas cotidianas como resumir un correo, proponer un esquema, reformular un párrafo o generar código. El resultado puede sonar muy fluido y, aun así, contener errores, datos inventados o una interpretación equivocada de lo que pedías. Que suene bien no es lo mismo que sea cierto.
Imágenes: De Una Descripción A Una Escena
Los modelos de imagen reciben una descripción en texto y producen una imagen. Existen distintas arquitecturas y procedimientos, así que no hay una única receta. Una idea general y prudente es esta: el modelo ha aprendido relaciones entre descripciones y patrones visuales, y al generar construye una imagen que encaja con tu petición según esos patrones.
Sirve para crear la ilustración de una instalación solar, cambiar el estilo de un esquema o producir una portada conceptual. Pero hay que mirar con lupa: puede haber errores en los rótulos, en la anatomía o en conexiones técnicas que parecen plausibles sin serlo. Más de una vez, un cartel dentro de una imagen generada parece escrito en un idioma que todavía no existe.
Audio: Regularidades En El Tiempo
Los modelos de audio pueden generar voz, música, efectos o transformaciones de sonido a partir de texto, de audio de referencia o de otras entradas, según el sistema. Aquí lo que se aprende son regularidades acústicas y temporales: cómo se encadenan los sonidos y cómo se organizan en el tiempo.
💡 Al señor Idea se le enciende una duda…
«¿La IA ha creado algo nuevo o ha preparado una ensalada con todo lo que aprendió? ¡Espero que no le haya puesto pasas!»
Durante el entrenamiento, el modelo aprende patrones que después utiliza para generar texto, imágenes o audio. Puede producir resultados nuevos, pero también equivocarse. Que tenga buena pinta no significa que todos los ingredientes sean correctos.
Ejemplos: una locución, una lectura en otro estilo o un ambiente sonoro. Pero que el modelo produzca música no significa que tenga oído, intención musical o experiencia. Y hay una cuestión importante: conviene respetar los derechos, los permisos de voz y la identidad de las personas.
Una IA generativa no inventa de la nada: aplica lo que aprendió a lo que le pides. Tú pones el criterio.
Por Qué Puede Equivocarse
Hay varias razones, y conviene tenerlas a mano:
- El modelo busca una salida probable o compatible con sus patrones, no una garantía automática de verdad.
- Los datos de entrenamiento pueden ser incompletos, sesgados o contradictorios.
- La petición puede ser ambigua, y el modelo rellena huecos a su manera.
- Una respuesta fluida puede esconder una inferencia incorrecta.
- En imágenes y audio, un resultado convincente puede incluir detalles imposibles o atribuciones falsas.
Por eso la revisión humana, el contraste con fuentes y la comprobación del resultado siguen siendo necesarios.
Para Quedarnos
Resumiendo: en el entrenamiento, el modelo ajusta sus parámetros con muchos ejemplos. En la generación, usa esos patrones para responder a algo nuevo. Con texto, imagen o audio cambia la forma de los datos, pero la idea de fondo es parecida. Generar contenido, eso sí, no equivale a comprender como lo hace una persona. Es una herramienta potente, y como toda herramienta, mejor usarla con criterio.
Para Ampliar Información
- Qué es la inteligencia artificial: explicación sencilla y ejemplos cotidianos (LedSolEo)
- IA, machine learning y deep learning: diferencias (LedSolEo)
- Neuronas reales y artificiales (LedSolEo)
- Google for Developers: Machine Learning Glossary
- Google for Developers: fundamentos de redes neuronales (glosario)
- NCBI: neurociencia, contexto sobre neuronas y sinapsis