Pensar paso a paso ya no es un truco: qué es hoy el prompting avanzado
▶ Escuchar este artículo (15 min 16 s)
Resumir este artículo con: ChatGPT
 Claude
 Grok
 DeepSeek
 Perplexity
Si llevas un tiempo usando ChatGPT o algún asistente parecido, seguro que te han soplado el conjuro: «piensa paso a paso». Durante un tiempo fue lo más parecido a un «abracadabra» de la inteligencia artificial. Y lo curioso es que funcionó, con papeles, cifras y todo.
Lo más interesante es lo que ha pasado después. En 2026, con modelos entrenados para razonar por su cuenta, esa fórmula ya no es la reina de la fiesta. Un estudio reciente la ha medido y, en ciertos casos, rinde menos. Además, varios trabajos de investigación avisan de que los «pasos» que vemos en pantalla no son una radiografía fiel de lo que el modelo calcula por dentro.
¿Significa eso que el *prompting avanzado* (el arte de redactar bien lo que le pides a una IA) ha muerto? Al contrario: el truco se jubila, pero la habilidad sigue. Vamos por partes.
2022: un hallazgo real, con números
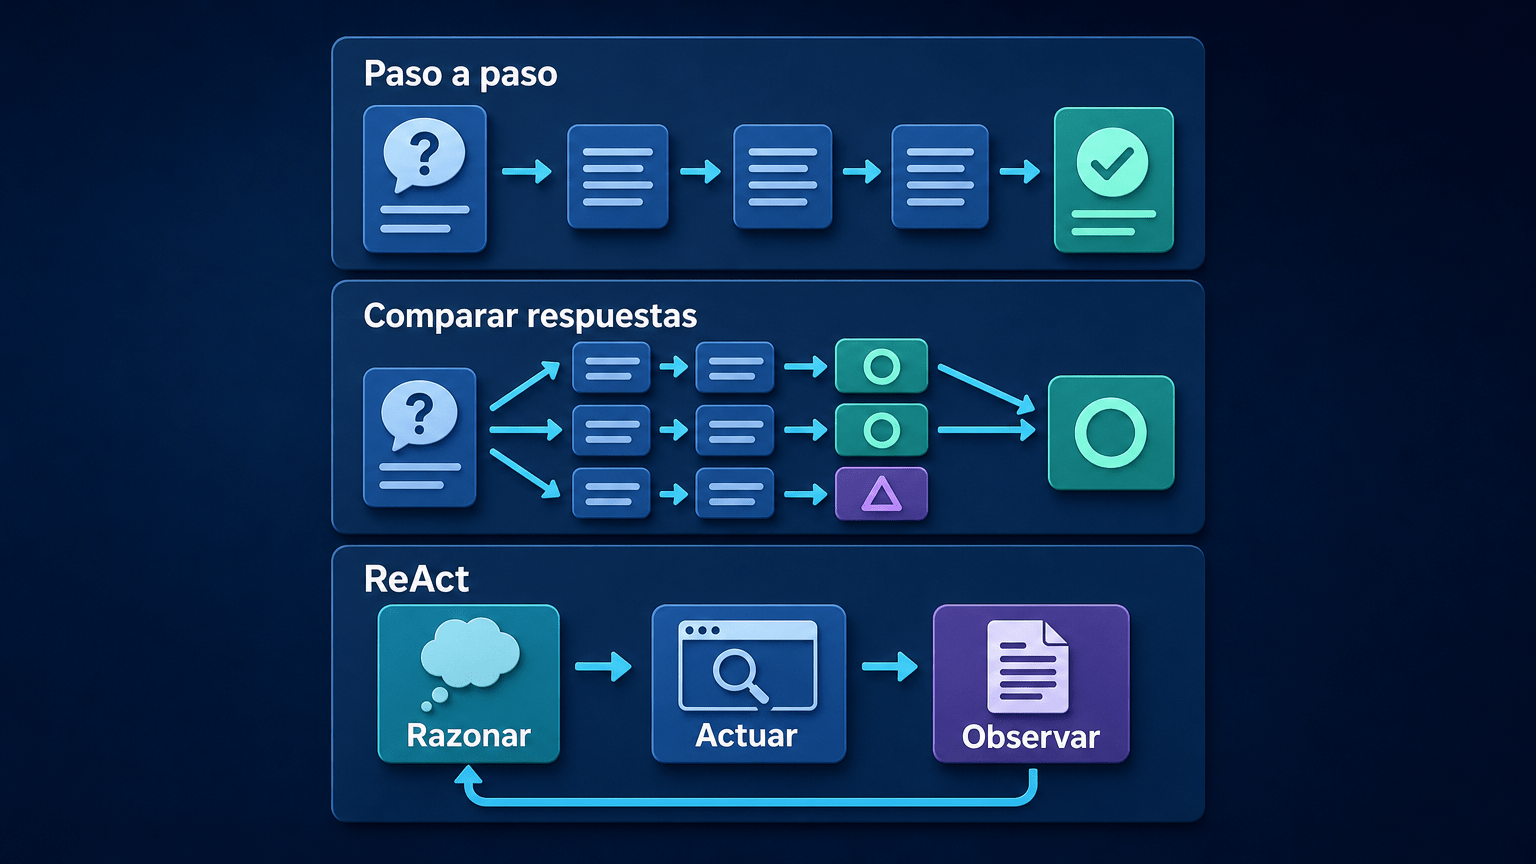
Todo empieza el 28 de enero de 2022, cuando un equipo de investigadores publicó el artículo «Chain-of-Thought Prompting Elicits Reasoning in Large Language Models». Su idea se puede resumir así: en lugar de pedirle a un modelo solo la respuesta final, se le enseñan unos pocos ejemplos en los que el problema se resuelve mostrando los pasos intermedios. A eso se le llamó «cadena de pensamiento» (en inglés, *chain of thought*): una serie de pasos escritos que llevan del enunciado al resultado.
El resultado fue llamativo. Con ocho ejemplos de ese tipo, un modelo de 540.000 millones de parámetros (los ajustes internos que el modelo fija al entrenarse) alcanzó el estado del arte en GSM8K, una batería de problemas de matemáticas planteados con palabras. Superó incluso a un GPT-3 ajustado con un verificador.
Conviene retener un matiz que casi nunca se cuenta: el efecto emergía en modelos suficientemente grandes. No era magia universal, sino una capacidad que aparecía cuando el modelo tenía cierto tamaño.
Si quieres repasar qué hay debajo de estos sistemas, tienes una explicación de qué es un LLM y cómo funciona la inteligencia artificial que genera texto.
La versión de bolsillo: «piensa paso a paso»
Preparar ejemplos a mano es un trabajo. Por eso, el 24 de mayo de 2022, otro equipo publicó algo mucho más cómodo: «Large Language Models are Zero-Shot Reasoners», aceptado en NeurIPS 2022. Su hallazgo: basta con añadir la frase «Let’s think step by step» (en castellano, «pensemos paso a paso») antes de la respuesta para que el modelo se convierta en un razonador decente sin ningún ejemplo.
Las cifras que dieron son estas, con el modelo text-davinci-002:
- En MultiArith (problemas de aritmética), la precisión pasó del 17,7 % al 78,7 %.
- En GSM8K pasó del 10,4 % al 40,7 %.
- Con PaLM, un modelo de 540.000 millones de parámetros, hubo mejoras del mismo orden.
Esa es la razón de que la frase se hiciera famosa. Demostró que se podía sacar razonamiento de un modelo sin preparar nada: una frase y listo. Y de ahí nació la leyenda de que «piensa paso a paso» funciona siempre. Spoiler: es la parte que no ha envejecido bien.
Varios caminos, una respuesta
Ese mismo año hubo otra idea con mucho recorrido: la auto-consistencia, publicada el 21 de marzo de 2022 (y presentada en ICLR 2023). Parte de una intuición cotidiana: un problema complicado admite muchos caminos de razonamiento, pero solo tiene una respuesta correcta.
Así que, en lugar de fiarse de un único camino, se le pide al modelo que genere varios distintos y se elige la respuesta que más se repite. Es lo que haces tú cuando haces la cuenta dos veces por métodos distintos y, si salen lo mismo, te quedas tranquilo.
Las mejoras sobre la cadena de pensamiento corriente fueron de +17,9 % en GSM8K, +11,0 % en SVAMP, +12,2 % en AQuA, +6,4 % en StrategyQA y +3,9 % en ARC-challenge. El artículo completo está en la sección de fuentes. Un apunte de sentido común, esto sí es análisis y no un dato del estudio: generar varias respuestas cuesta más que generar una. Mejorar tiene precio.
De razonar a actuar: el abuelo de los agentes
El 6 de octubre de 2022 llegó ReAct (presentado en ICLR). Hasta entonces, el razonamiento (la cadena de pensamiento) y la acción (los planes para hacer cosas) se estudiaban por separado. ReAct los entrelaza: el razonamiento ayuda a inducir, seguir y corregir el plan, y las acciones permiten consultar fuentes externas.
Con solo uno o dos ejemplos, mejoró en 34 puntos absolutos la tasa de éxito de los métodos de imitación y aprendizaje por refuerzo en ALFWorld, y en 10 puntos en WebShop.
Hoy es el antecedente directo de los agentes que consultan herramientas. Si quieres ver hacia dónde evolucionó esa idea, mira cómo MCP conecta la IA con tus herramientas.
2026: cuando la guía distrae
Hasta aquí, la historia clásica. Ahora, el giro.
El 4 de agosto de 2026 se publicó «Soft Guidance Starts to Outperform CoT Prompting as LLMs Improve». Los autores probaron varios modelos actuales de tamaño medio en una tarea de matemáticas y compararon dos formas de pedir las cosas: el clásico prompting con ejemplos de cadena de pensamiento y la simple petición directa.
El hallazgo es este: en los modelos especializados en razonamiento, dejarles responder sin ejemplos superó al prompting con ejemplos. En Mathstral, sobre GSM8K, la cifra subió de ~77 % a ~84 %. Y en el modelo de propósito general que probaron, la petición directa igualó o superó al método clásico.
La explicación que dan los autores es un compromiso entre guía y distracción. Imponer el formato obliga al modelo a adaptarse a un estilo, cumplir una plantilla y cargar con contexto que no necesita, y eso lo distrae de la tarea. Su conclusión es que usar el prompting clásico de cadena de pensamiento distrae cada vez más a medida que los modelos mejoran.
Dos precauciones para no pasarnos de frenada:
- No es una ley universal. Es un experimento en matemáticas con modelos de tamaño medio. En otras tareas (redactar, programar, resumir), las fuentes que manejamos no nos dan datos.
- No dice que «explicar» sea inútil. Dice que *imponer el formato de razonamiento* a un modelo que ya razona puede ser un lastre.
El truco se jubila; la habilidad, no.
Dos familias de modelos (y no, una no es «la buena»)
La que piensa despacio y la que corre rápido: no es cuál es mejor, es para qué
Modelos de razonamiento y modelos GPT según la documentación oficial de OpenAI · Datos según las fuentes citadas, a fecha de publicación del artículo (11 de noviembre de 2026)
OpenAI reparte sus modelos en dos familias y avisa de que ninguna es mejor que la otra: solo sirven para cosas distintas.
Esta tabla compara cómo trabaja cada una y para qué tareas encaja. No es una clasificación de calidad: es una guía para elegir antes de escribir la petición.
Si no ves todas las columnas, puedes deslizar la tabla hacia los lados.
| Criterio | Modelos de razonamiento | Modelos GPT |
|---|---|---|
| Apodo en la documentación | «Los planificadores» | «Los caballos de tiro» |
| Cómo trabajan | Piensan más y más despacio antes de responder | Responden rápido y salen más baratos |
| Encajan mejor en | Estrategia, planes y decisiones con información ambigua | Ejecutar tareas bien definidas y repetitivas |
| Qué cuesta | Más tiempo y más dinero por respuesta | Menos tiempo y menos coste |
1 Datos según las fuentes citadas, a fecha de publicación del artículo (11 de noviembre de 2026). El módulo no actualiza nombres ni precios: solo sitúa lo que decía la documentación ese día.
2 Los apodos «los planificadores» y «los caballos de tiro» son los que usa la propia documentación de OpenAI; no son nuestros.
3 Las familias y sus nombres cambian a menudo. Lo que se compara aquí es la forma de trabajar, no un catálogo cerrado de modelos.
Documentación oficial consultada: OpenAI · buenas prácticas para modelos de razonamiento · Anthropic · pensamiento adaptativo y coste.
La mirada de LedSolEo
Emparejar el modelo con la tarea
La pregunta «¿cuál es el mejor modelo?» es una trampa, y la propia documentación lo dice sin rodeos: hay uno que planea y otro que ejecuta.
La otra mitad del trabajo no depende del modelo. Si el objetivo está claro, el contexto es el correcto y compruebas lo que te devuelve, casi cualquier familia sirve; cuando eso falta, ni el modelo más lento y caro lo arregla.
Nuestra lectura: empareja el modelo con la tarea y quédate con la costumbre de comprobar. El conjuro no hace falta.
Como la tabla enfrenta dos formas de trabajar, conviene no leerla como «cuál es mejor», sino como «para qué sirve cada cual». Un planificador cuesta más y tarda más; para renombrar cuarenta archivos, un caballo de tiro es más que suficiente.
Lo que más nos interesa es el consejo de la documentación sobre cómo pedirles las cosas a los modelos de razonamiento:
- Dar directrices concretas, como «propón una solución con un presupuesto por debajo de 500».
- Explicar muy bien el objetivo final.
- Animar al modelo a seguir razonando e iterando hasta cumplir el criterio de éxito.
Nótese lo que *no* aparece: ni una palabra de «piensa paso a paso». Eso es lo que el modelo ya sabe hacer solo. Y un detalle curioso de la misma documentación: en los modelos de razonamiento, el formato Markdown (negritas, listas, títulos) viene desactivado por defecto. Si lo quieres, hay que pedirlo explícitamente.
Pensar solo cuando hace falta
El segundo cambio llega por el lado del coste. Según la documentación de Anthropic sobre pensamiento y coste (consultada el 10 de noviembre de 2026), el pensamiento extendido con presupuesto fijo (la función que se activaba con budget_tokens) figura ya como función heredada: está desaconsejada y los modelos Claude 4.7 y posteriores la rechazan con un error.
La alternativa recomendada es el pensamiento adaptativo: el modelo decide si piensa y cuánto en cada petición. Con esfuerzo bajo, incluso puede no pensar nada en lo fácil.
Es el GPS de la IA. Cuando la ruta es una recta, apenas se despeina; cuando hay obras y tráfico, recalcula con más ganas. Y el presupuesto manual tenía su letra pequeña: mínimo de 1.024 tokens (trozos de texto, más o menos sílabas o palabras cortas) y era un objetivo, no un techo, de modo que el modelo podía parar antes.
La idea es la de siempre en los servicios con tarifa: no es lo mismo una consulta rápida que una auditoría completa. El mismo profesional, distinto tiempo, distinto precio. Si te interesa la filosofía del ecosistema que está detrás, puedes leer sobre la filosofía de Claude, el contexto de un millón de tokens y los Artifacts.
Lectura nuestra, no dato de ninguna fuente: «pensar» ha dejado de ser un interruptor que activas a mano con una frase mágica. Ahora es algo que el sistema dosifica según la tarea y según lo que cuesta.
Lo que ves no es exactamente lo que calcula
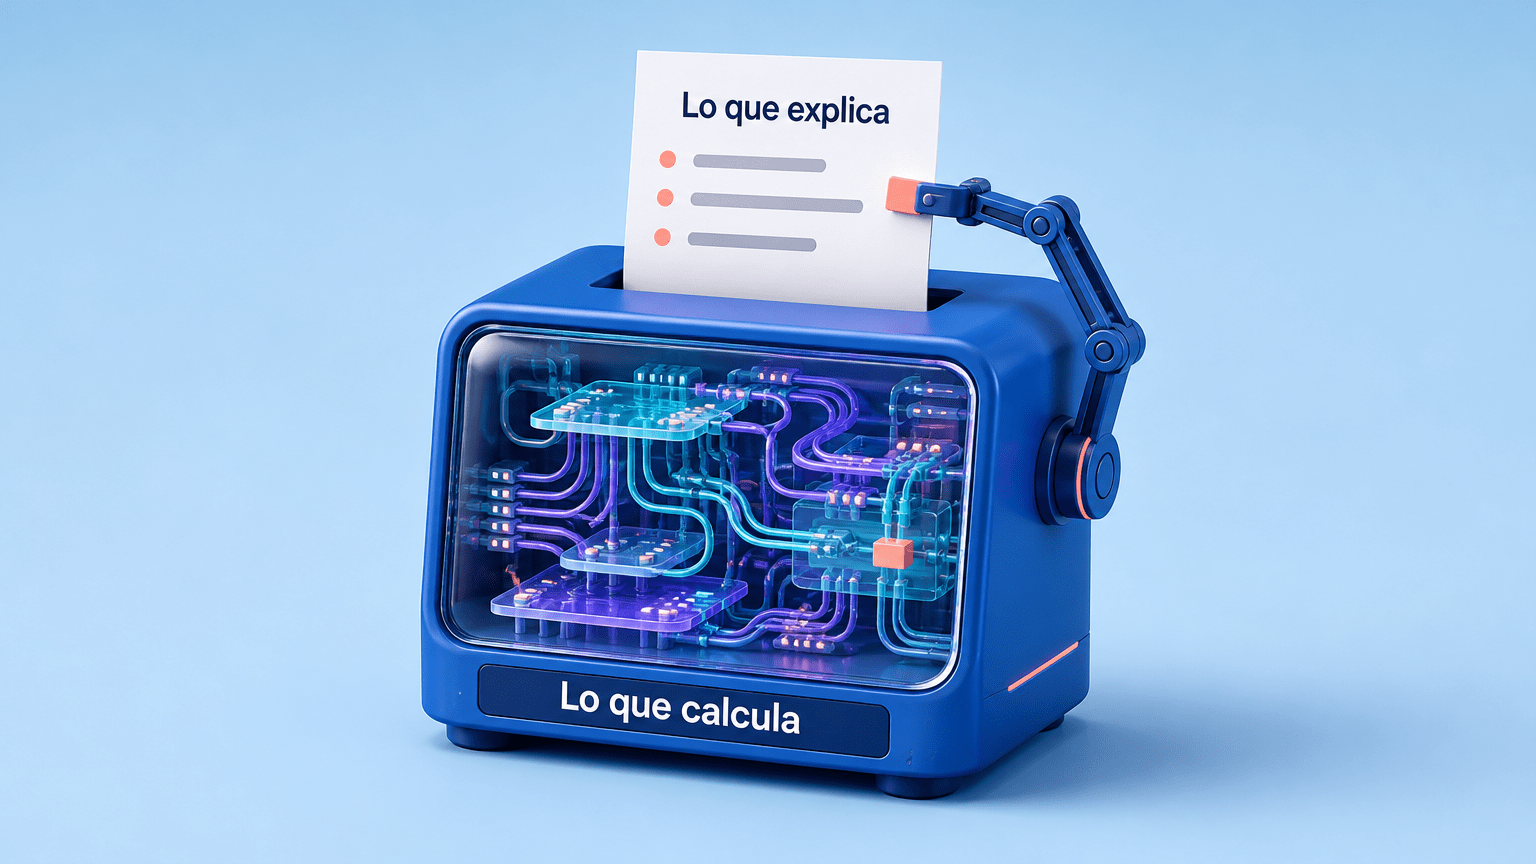
Queda el tercer matiz, el más delicado. Muchos asistentes nos enseñan ahora una especie de «razonamiento» en pantalla. Es tentador leerlo como la transcripción de lo que «piensa» el modelo. Pero varios trabajos presentados en EMNLP 2026, uno de ellos centrado en cómo estas trazas representan mal el cálculo subyacente, apuntan a otra cosa: las trazas que generan estos sistemas pueden no reflejar el cálculo real que los lleva a la respuesta.
Entre las razones que se proponen está el ancho de banda: un token (un trozo de texto) lleva poca información comparado con el estado interno del modelo. Pero ese límite no explica todos los casos observados, y los trabajos señalan cómo se entrenan estos sistemas como causa principal. Otro trabajo del mismo congreso muestra que se puede inducir comportamiento de razonamiento interviniendo en representaciones internas concretas, sin pedir ninguna cadena de pensamiento.
Esto es investigación abierta, y no hay que exagerarla. No dice que los modelos «mientan», ni que lo que vemos no sirva de nada. Dice, con prudencia, que la traza visible es una explicación, no una garantía. Sirve para que podamos seguir la respuesta, no como prueba de que el modelo ha llegado a ella con esas palabras.
Piensa en el fontanero que va charlando mientras trabaja. Lo que cuenta es útil y te da una idea del trabajo, pero no es exactamente lo que hacen sus manos. Aun así, tú verificas que el grifo deja de gotear.
Entonces, ¿qué funciona hoy?
Si lo que has leído hasta aquí te parece que desmonta el prompting, mira lo que queda en pie, que es, de hecho, lo que siempre ha funcionado. Ese es el *prompting avanzado* de verdad:
- Dar el contexto que hace falta. No es lo mismo decirle a un cocinero «hazme de comer» que enseñarle lo que hay en la nevera, lo que hay que evitar y para cuántos comensales son. Si trabajas con tus propios documentos, mira qué es RAG y cómo conseguir que una IA responda con tus documentos.
- Explicar el objetivo final y el criterio de éxito. Es literalmente lo que recomienda la documentación de OpenAI: directrices concretas, objetivo claro y seguir iterando hasta cumplirlo.
- Dar ejemplos de calidad de lo que quieres como resultado. Esto es análisis nuestro, no conclusión del estudio de 2026: lo que ese trabajo mide es el coste de *imponer el formato de razonamiento*, no el valor de enseñar cómo es un buen resultado. Si los ejemplos ayudan o estorban en tu caso, solo lo sabrás probando.
- Comprobar el resultado. Si la traza no es una garantía, tu revisión sí lo es.
Y los cinco mitos, en una línea cada uno:
- «Piensa paso a paso» funciona siempre. No: fue un hallazgo de 2022 y hoy puede estorbar.
- Más pasos no es mejor respuesta. Obligar a un formato añade trabajo que no es la tarea.
- La traza no es lo que «piensa» el modelo. Es una explicación y puede no ser fiel.
- Un modelo que razona no es mejor en todo. Suele ser más lento y más caro; la propia OpenAI aconseja reservarlos para planificar o decidir.
- El prompting no son palabras mágicas. Es decir bien el objetivo, dar contexto y comprobar.
Cómo saber si te está sirviendo
Nada de fiarte de una receta ajena, incluida esta. Una prueba pequeña y honesta:
- Elige una tarea real tuya, de las que repites.
- Hazle la misma pregunta de dos maneras: una directa, con contexto y criterio de éxito, y otra con el formato clásico («piensa paso a paso», plantilla de pasos, etc.).
- Compara los resultados con algo que tú sepas comprobar: una cuenta que conoces, un dato que puedes mirar, un resultado que reconoces como bueno.
- Repite un par de veces, porque una sola respuesta puede ser casualidad.
Para ir más allá en la parte de verificar y citar fuentes, tienes Deep Research y NotebookLM: investigar y citar con IA.
Para cerrar
En 2022, pedirle a un modelo que mostrara sus pasos fue un descubrimiento medible. En 2026, los modelos que razonan por su cuenta nos recuerdan que la mejor instrucción suele ser la más clara, no la más ritual. Lo que sobrevive del viejo truco es lo que nunca fue un truco: explicar bien qué quieres, dar el contexto, definir qué es un buen resultado y comprobar la respuesta.
Para ampliar información
- El estudio original de la cadena de pensamiento (Wei y otros, 2022)
- «Piensa paso a paso» sin ejemplos: razonar sin mostrarle ninguno (Kojima y otros, 2022)
- Autocoherencia: preguntar varias veces y quedarse con lo que se repite (Wang y otros, 2022)
- ReAct: razonar y usar herramientas a la vez (Yao y otros, 2022)
- La guía suave ya supera a la cadena de pensamiento según mejoran los modelos (Pushkin y otros, 2026)
- OpenAI: buenas prácticas para modelos que razonan
- Anthropic: pensamiento extendido (documentación)
- Anthropic: pensamiento adaptativo y su coste
- EMNLP 2026: hasta qué punto la traza refleja el razonamiento real (PDF)