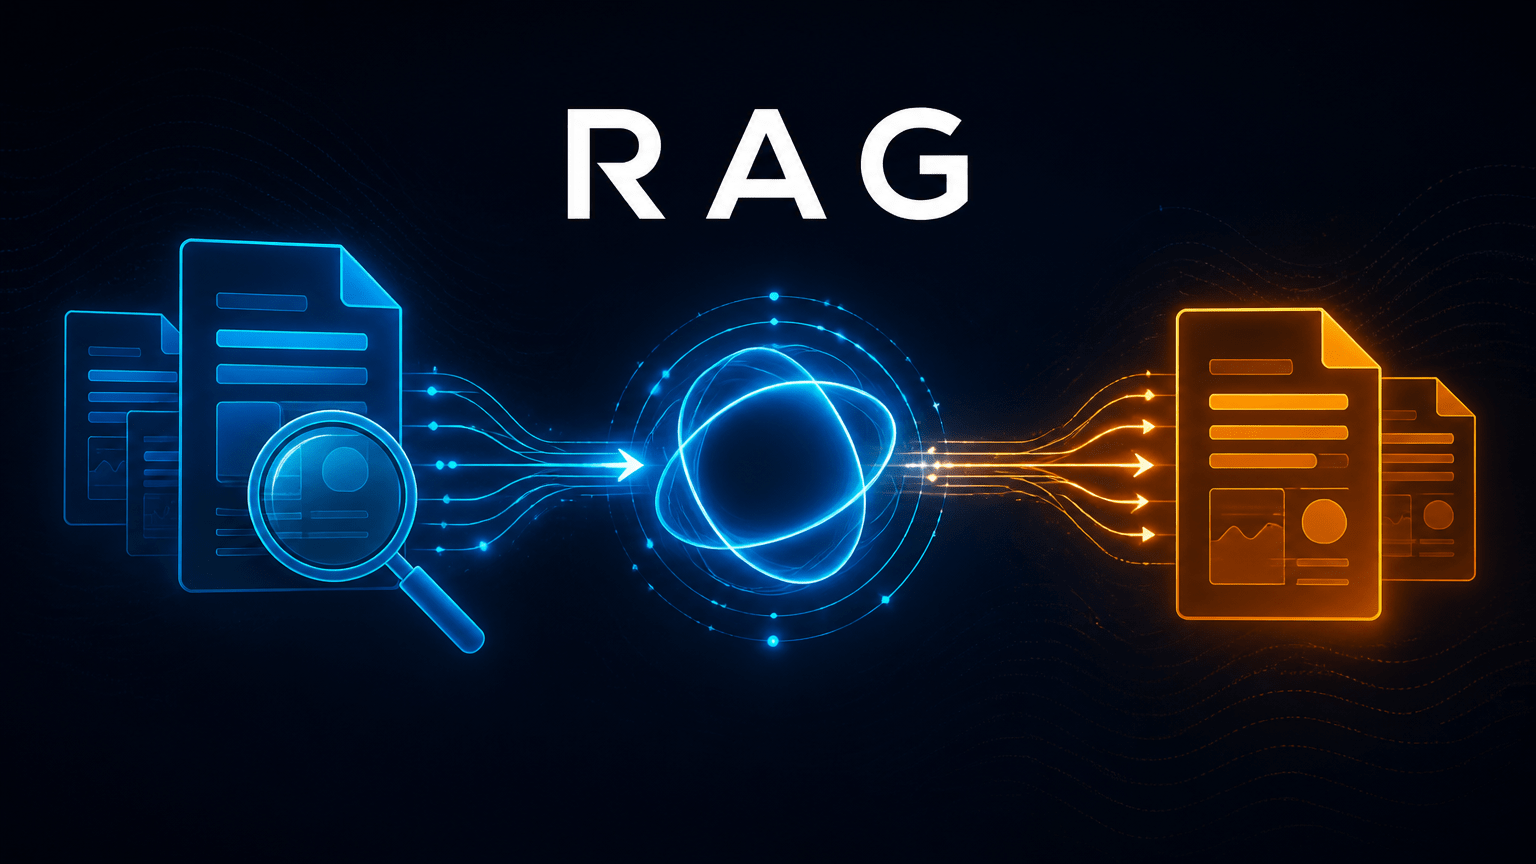
¿Qué es RAG? Cómo conseguir que una inteligencia artificial responda utilizando tus documentos
Tienes una carpeta con cientos de facturas, tres contratos y un correo donde alguien confirmó, hace meses, un cambio de precio. Necesitas ese dato concreto y no lo encuentras. Podrías abrir los archivos uno a uno, o podrías pedírselo a una inteligencia artificial… si supiera mirar dentro de tus documentos. Eso, en esencia, es RAG. Y en este artículo lo explicamos sin matemáticas y con ejemplos que cualquiera reconoce.
Lo que el modelo ya sabe… y lo que no
Cuando preguntas algo a un asistente como ChatGPT, la respuesta sale de lo que el modelo aprendió durante su entrenamiento: una cantidad enorme de texto que le permite saber qué es un LLM, resumir un concepto o escribir un correo decente. Ese conocimiento es amplio, pero tiene dos límites que notamos a diario.
El primero es que no incluye tus cosas. El modelo no conoce el número de factura de tu proveedor, ni el contenido de tu contrato, ni ese correo del precio. Podría inventarse una cifra que suena bien; el problema es que sonaría convincente y sería falsa.
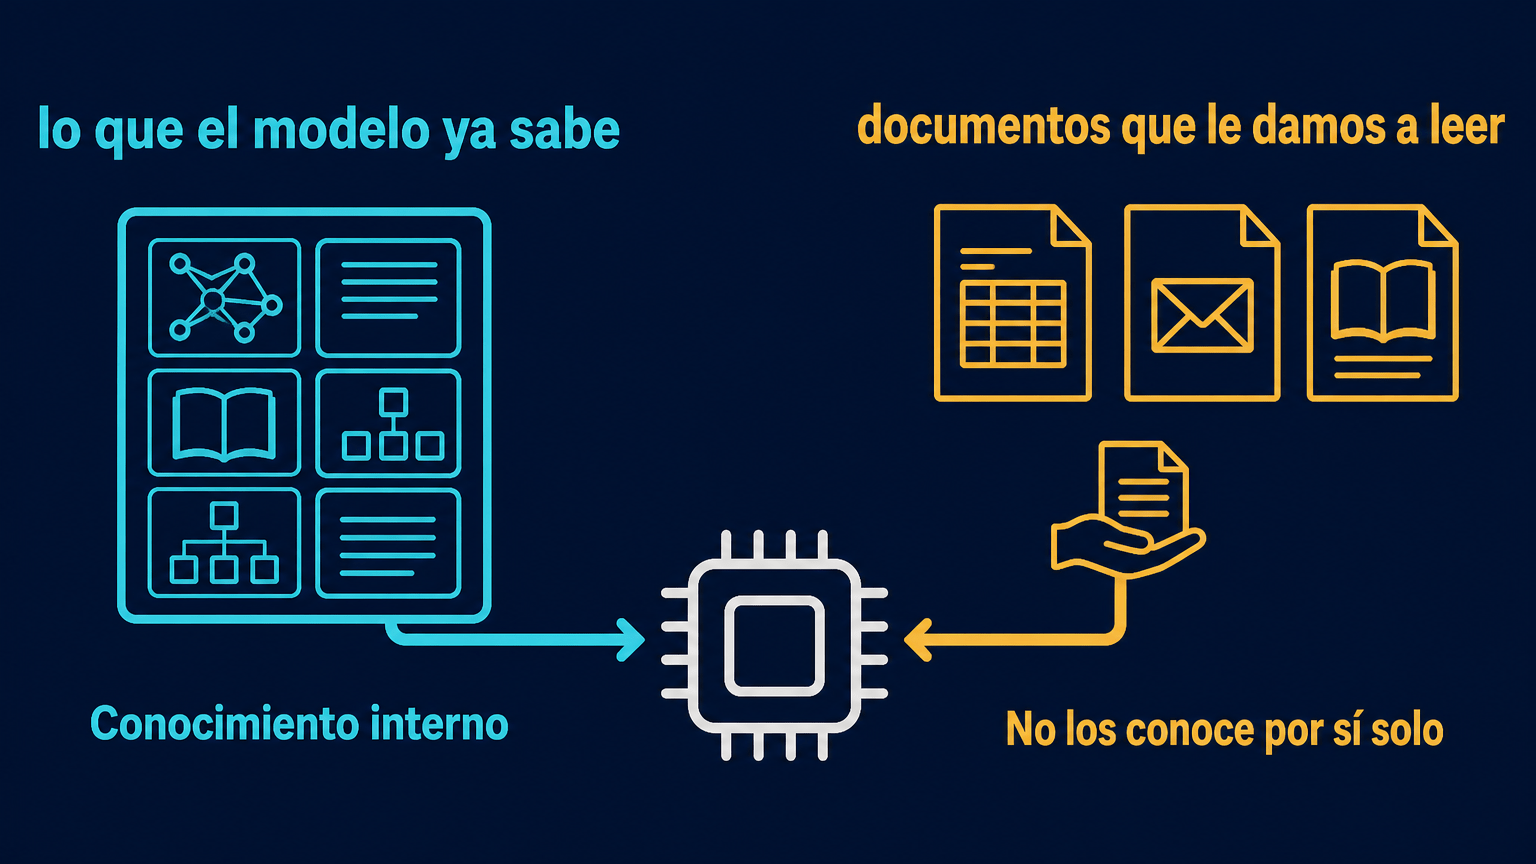
El segundo es que lo que sabe tiene fecha de caducidad. Cuanto más antiguo es el entrenamiento, más probable es que se le escapen cambios recientes. Aquí entra una idea clave: hay una diferencia entre lo que el modelo ya sabe (su memoria interna) y lo que le damos a leer (información que le aportamos nosotros). RAG vive en ese segundo mundo.
La metáfora del empleado que consulta el archivo
Piensa en dos empleados. Uno es brillante y ha leído muchísimo, pero nunca ha pisado tu oficina. El otro no lo sabe todo, pero antes de contestarte se levanta, va al archivo de la empresa y busca la carpeta adecuada. Obviamente, preferirás que quien te responda consulte antes los papeles correctos.
Eso es lo que hace RAG (Retrieval-Augmented Generation, «generación aumentada por recuperación»): darle al modelo la posibilidad de buscar la información que tú le proporcionas y leerla antes de responder. El nombre es técnico, pero la idea es doméstica: no se trata de que la IA lo recuerde todo, sino de que mire lo que le dejamos a mano.
Buscar, recuperar y responder: el recorrido de RAG
El proceso se resume en tres pasos:
- Buscar. Cuando haces una pregunta, el sistema no lanza el modelo a ciegas. Primero compara tu consulta con el conjunto de documentos disponibles y localiza los fragmentos que parecen más relevantes. Para lograrlo, los documentos se traducen a listas de números que representan su significado, no sus palabras exactas. Es lo que se conoce como embeddings: «la factura del proveedor» y «el recibo del mantenimiento» quedan «cerca» aunque casi no compartan palabras, y por eso la búsqueda encuentra lo importante aunque no uses el término exacto. Conviene matizarlo: esa cercanía es aproximada. Los embeddings captan el significado con notable acierto, pero no son infalibles; dos asuntos parecidos pueden quedar demasiado próximos y colarse en la recuperación.
- Recuperar y leer. Esos fragmentos concretos —y no toda la biblioteca— se seleccionan y se colocan «delante» del modelo junto con tu pregunta. El sistema recupera la información y la prepara para que el modelo pueda leerla.
- Responder. Ahora sí, el modelo redacta una respuesta usando, esta vez, esos fragmentos como base, e idealmente te dice de dónde la ha sacado. La frase que ves es nueva, pero está apoyada en material que existe y que puedes comprobar.
Dicho de otro modo: buscar, recuperar, responder. Ni magia ni caja negra; un procedimiento ordenado.
De la factura al correo: ejemplos de todos los días
Los tres pasos se entienden mejor con situaciones reales:
- Facturas y documentos de empresa. «¿Cuánto pagamos al proveedor de mantenimiento en el último trimestre?» RAG localiza las facturas pertinentes, recupera las líneas correctas y redacta la respuesta, citando los documentos usados.
- Correos y conversaciones. «¿Qué acordamos sobre el plazo de entrega?» El sistema busca en los mensajes, recupera el intercambio relevante y te resume el acuerdo sin que tengas que releer cien hilos.
- Documentación propia. Manuales, apuntes, informes o normativa interna. En lugar de hojear un PDF de ochenta páginas, preguntas y recibes el fragmento que responde, con su origen. Si trabajas con documentos, tienes una pista de por qué esto se parece tanto a «hablar con tus PDF» usando una IA local.
- Logística. «¿Qué pedidos de esta semana iban a Barcelona y se retrasaron?» Un ejemplo de libro: mucha información dispersa, una pregunta concreta y una respuesta útil si la recuperación funciona bien.
Fíjate en el patrón: no preguntas por cultura general, preguntas por tu información. Es ahí donde RAG marca la diferencia. (Y si quieres ordenar el vocabulario —cuándo se habla de inteligencia artificial, de machine learning o de deep learning— lo aclaramos en estas diferencias.)
RAG no es magia: errores, citas y verificación
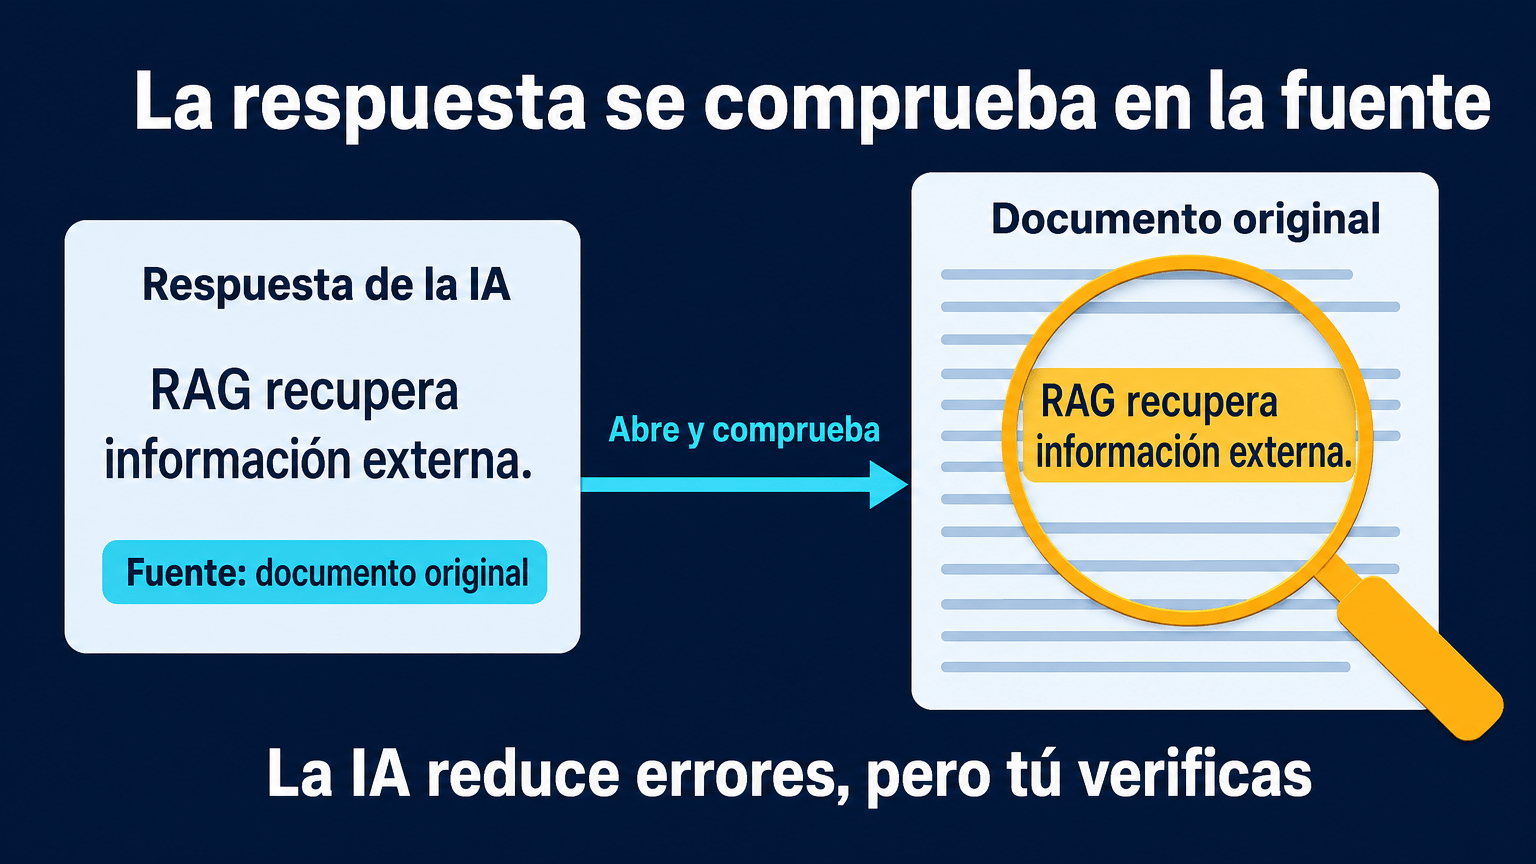
Conviene decirlo claro, porque es fácil dejarse deslumbrar: RAG reduce errores, pero no garantiza respuestas correctas. Puede buscar en el sitio equivocado, recuperar un fragmento incompleto o interpretar mal un documento ambiguo. Y, al redactar, siempre existe el riesgo de añadir algo que no estaba en la fuente.
Por eso la comprobación es parte del método, no un trámite opcional:
- Mira la fuente recuperada. Si la respuesta cita un documento, ábrelo y confirma que dice lo que se le atribuye.
- Desconfía de las citas perfectas. Una referencia que aparece impecable también puede estar mal asociada; la cita ayuda, no sustituye tu lectura.
- Comprueba los datos sensibles. Cifras, fechas, importes y nombres propios merecen una segunda mirada siempre.
Una IA que consulta tus documentos es un buen ayudante, no un notario. La regla práctica: cuanto más importante sea la decisión, más se revisa.
Permisos, privacidad y confidencialidad
Hay una pregunta que surge enseguida: ¿y mis archivos? Tres aclaraciones útiles:
- Tus documentos no se incorporan automáticamente al entrenamiento del modelo. Que el sistema lea un archivo para responder no significa que lo aprenda para siempre. Son cosas distintas y conviene no confundirlas.
- El acceso debe respetar permisos. No todo el mundo debe poder consultar toda la documentación. Si un sistema recupera información, debe hacerlo solo sobre aquello que el usuario tiene derecho a ver.
- La confidencialidad importa. Facturas, contratos o datos personales son material sensible. Antes de conectar documentos conviene saber dónde se guardan, quién puede consultarlos y con qué límites.
La comodidad de «preguntar y que me lo encuentre» no debería costarnos el control sobre nuestra propia información.
Qué llevarte de todo esto
RAG no añade memoria infinita a la inteligencia artificial: le da acceso ordenado a tus documentos. En lugar de fiarlo todo a lo que el modelo recuerda, le enseñamos a mirar el archivo correcto antes de contestar. Tres pasos —buscar, recuperar, responder— y una costumbre que no cambia: comprobar. Si mañana conectas tus facturas, tus correos o tus manuales a un asistente, ya sabrás qué está pasando por dentro… y qué no deberías dar por sentado.
Para ampliar información
- Qué son los embeddings
- Qué es un LLM y cómo funciona
- Cómo hablar con tus PDF utilizando una IA local
- IA, machine learning y deep learning: diferencias
Fuentes sobre RAG (verificadas):
- Lewis, P. y otros (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. arXiv:2005.11401
- Gao, Y. y otros (2023). Retrieval-Augmented Generation for Large Language Models: A Survey. arXiv:2312.10997