Aprendizaje supervisado y no supervisado: cómo aprende una inteligencia artificial
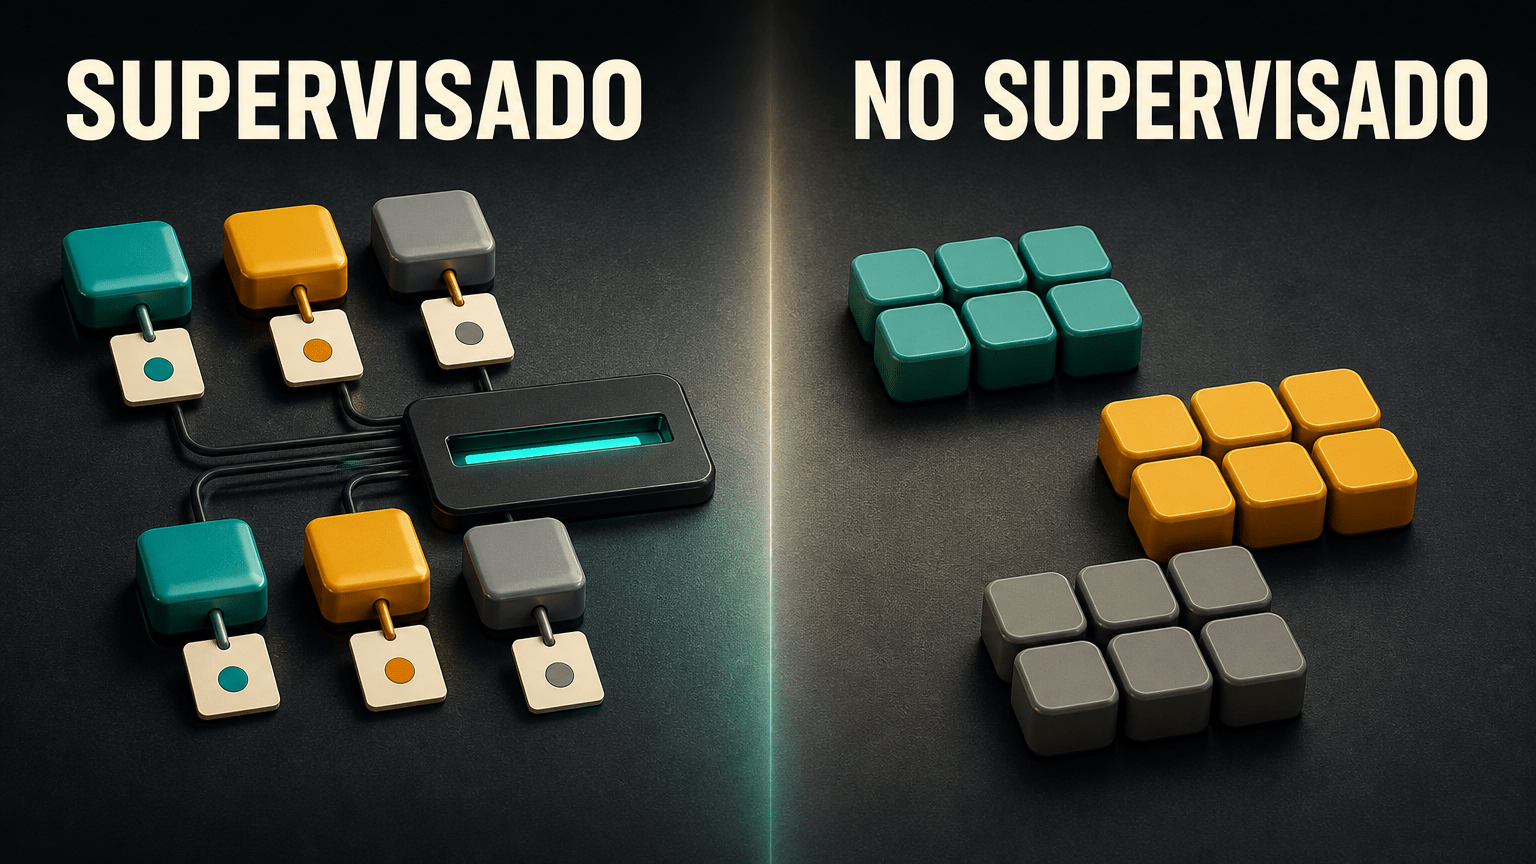
Cuando alguien dice que una inteligencia artificial «ha aprendido», conviene preguntar cómo. No es lo mismo aprender con un profesor que te corrige cada ejercicio que aprender explorando un montón de material sin que nadie te diga qué buscar. En el aprendizaje automático ocurre algo parecido, y de ahí sale la distinción entre aprendizaje supervisado y no supervisado, la más útil para orientarse entre los distintos tipos de machine learning.
¿Qué significa que una máquina «aprenda»?
Para una máquina, aprender es ajustar números a partir de ejemplos. Un modelo es una fórmula con muchísimos valores internos que se retocan poco a poco durante el entrenamiento, hasta que sus resultados mejoran.
Una persona aprende entendiendo: sabe qué es un gato, por qué maúlla y que no le gusta el agua. El modelo no entiende nada de eso: encuentra relaciones estadísticas entre los datos que recibe, como «las imágenes con estas formas suelen llevar la palabra gato». Si te cuesta imaginarlo, piensa en un opositor que se ha aprendido mil exámenes de memoria sin saber de qué trata la asignatura: aprueba bastante… hasta que cambian las preguntas.
Si quieres repasar el marco general, lo tienes en Qué es la inteligencia artificial: explicación sencilla con ejemplos cotidianos y en IA, machine learning y deep learning: diferencias con ejemplos. Aquí nos centramos en cómo se aprende.
Datos de entrenamiento y etiquetas
Imagina una hoja de cálculo. Cada fila es un ejemplo: un piso, un correo, una foto. Las columnas con sus datos (metros cuadrados, barrio, año de construcción) son las características. Si además hay una última columna con la respuesta correcta («precio: 210.000 euros»), esa columna es la etiqueta.
El conjunto de todas esas filas es lo que se llama datos de entrenamiento. Que tengan o no la columna de respuestas es lo que separa los dos grandes enfoques.
Aprendizaje supervisado: aprender con la respuesta delante
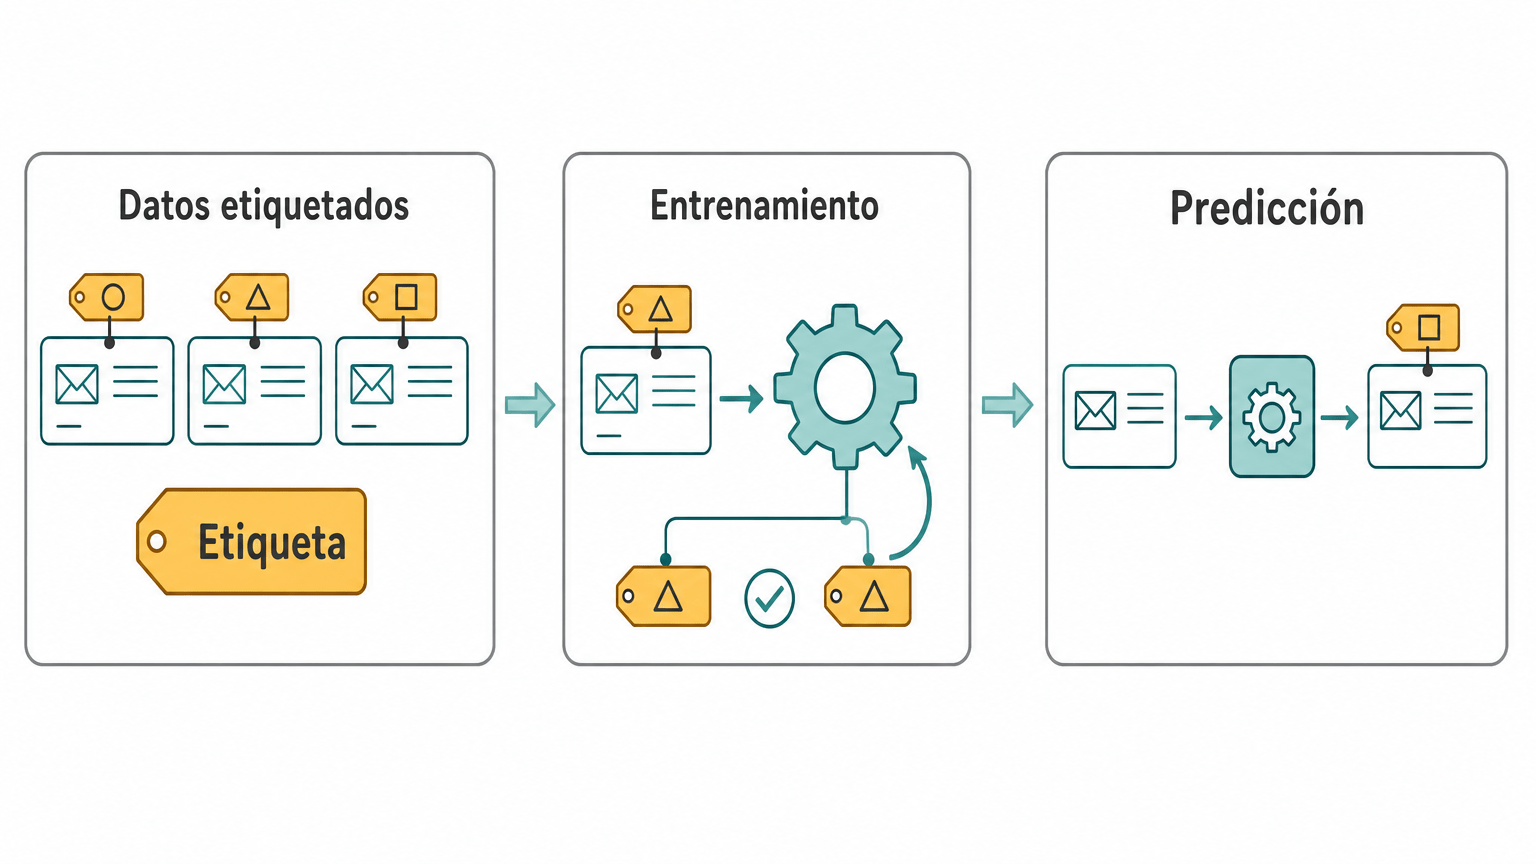
Si te preguntas qué es el aprendizaje supervisado, la respuesta corta es esta: aprender con ejemplos cuya respuesta ya conocemos. El modelo recibe las características, hace una predicción y la compara con la etiqueta real. La diferencia entre ambas es el error, y el entrenamiento consiste en ajustar los valores internos para que ese error sea cada vez menor. Es el mecanismo que describe Google en su material sobre aprendizaje supervisado.
Cuando el modelo ya está entrenado y evaluado, se usa para inferir: darle datos nuevos, sin etiqueta, y que proponga la respuesta.
Ejemplo cotidiano: reconocer correos no deseados
Tu bandeja de entrada es un buen laboratorio. Se reúnen miles de mensajes que personas han marcado previamente como «no deseado» o «normal». El modelo estudia qué tienen en común unos y otros: ciertas expresiones, enlaces extraños y un entusiasmo sospechoso por los premios inesperados.
Con ese aprendizaje, cuando llega un correo nuevo estima a cuál de los dos grupos se parece más. Sin esas etiquetas humanas no habría nada de lo que aprender: el modelo no sabe qué es el spam, solo sabe qué se parecía a lo que alguien marcó como spam.
Clasificación y regresión, sin fórmulas
El aprendizaje supervisado se reparte en dos tareas, que son sus dos caras:
- Clasificación: predecir una categoría. Spam o no spam; gato, perro o caballo.
- Regresión: predecir un número. El precio de una vivienda, la temperatura de mañana o los minutos que durará un trayecto.
La pregunta para distinguirlas es sencilla: ¿la respuesta es una etiqueta de una lista o una cantidad? En ambos casos el modelo se entrena con respuestas conocidas.
Aprendizaje no supervisado: buscar patrones sin respuestas
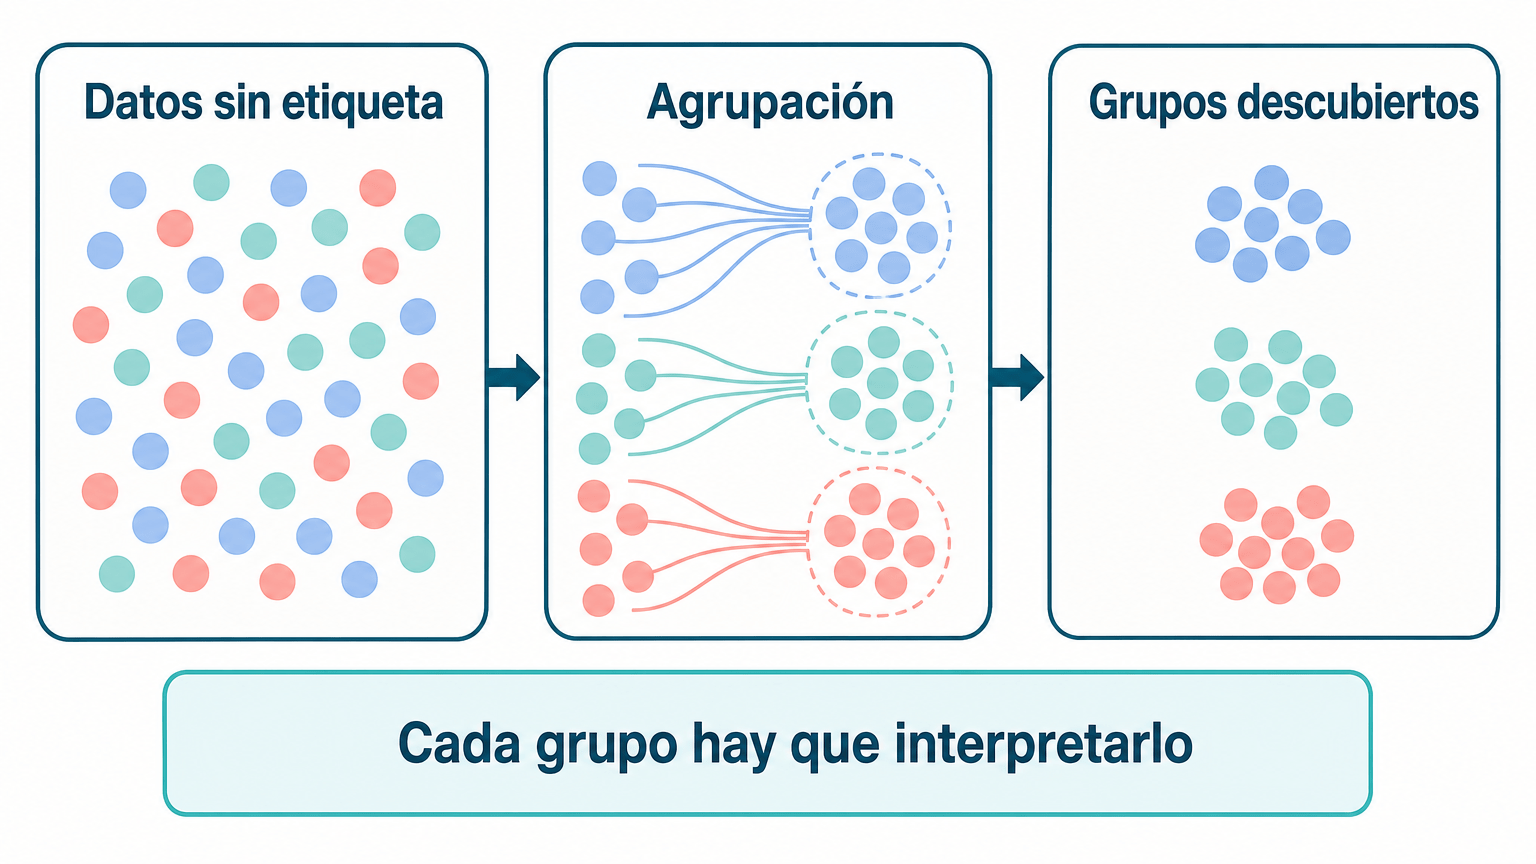
Ahora quitamos la columna de respuestas. En el aprendizaje no supervisado el sistema trabaja con datos sin etiquetar e intenta encontrar estructura por su cuenta: qué elementos se parecen, cuáles se separan, qué variables se mueven juntas. Así lo recogen IBM y el curso de agrupación de Google, que trata precisamente de organizar datos sin respuestas previas.
Hay una advertencia importante: los grupos que aparecen no son «la verdad» del conjunto de datos. Dependen de los datos recogidos y del método elegido, y con otros distintos podrían salir otros grupos. El algoritmo tampoco explica qué significa cada uno, así que hace falta una persona que valide si el resultado tiene sentido.
Ejemplo cotidiano: agrupar clientes parecidos
Una tienda online tiene el historial de compras de sus clientes, pero nadie ha definido «tipos de cliente». Se le pide al algoritmo que junte a los que se comportan de forma similar: frecuencia de compra, importe medio, productos habituales.
Salen, por ejemplo, cuatro grupos. Aquí el trabajo pasa a las personas: alguien los mira, observa qué tienen en común y les pone nombre (tal vez «compradores de rebajas» o «clientes de todo el año»). y decide si merece la pena hacer algo con ellos. El algoritmo propone una forma de ordenar los datos; la interpretación y la decisión son cosa nuestra.
Agrupación y reducción de dimensionalidad
La agrupación (en inglés, clustering) consiste en «juntar lo que se parece». En un método muy conocido, k-means, se elige de antemano cuántos grupos se quieren, y cada elemento se asigna al grupo cuyo centro le queda más cerca. La documentación de scikit-learn recoge este y otros métodos.
No hay que confundirla con la clasificación. Clasificar es colocar un elemento en categorías que ya existen y tienen nombre («spam», «gato»). Agrupar es descubrir grupos que antes no estaban definidos, y que salen sin nombre.
La reducción de dimensionalidad resuelve otro problema: demasiadas columnas. Imagina una ficha de cada coche con cincuenta medidas: muchas dicen casi lo mismo y se resumen en unas pocas ideas, como «tamaño» o «potencia». Reducir dimensiones es condensar esas columnas sin perder lo esencial, y sirve para visualizar datos y como paso previo a otras técnicas.
Diferencias, ventajas y limitaciones
Las diferencias entre aprendizaje supervisado y no supervisado se ven bien lado a lado:
| Aspecto | Aprendizaje supervisado | Aprendizaje no supervisado |
|---|---|---|
| Qué datos necesita | Datos etiquetados: características y respuesta conocida | Datos sin etiquetar: solo características |
| Qué objetivo tiene | Predecir una categoría o un número | Descubrir estructura, parecidos o patrones |
| Ejemplos típicos | Detectar spam, estimar el precio de un piso | Agrupar clientes, resumir muchas variables en pocas |
| Ventaja principal | Resultados medibles y, por lo general, más precisos | No requiere etiquetar a mano; explora grandes volúmenes de datos |
| Dificultad principal | Etiquetar datos cuesta tiempo y trabajo humano | Los resultados son más difíciles de validar e interpretar |
La calidad de los datos, los sesgos y la evaluación
Un modelo vale lo que valen sus datos. Si los ejemplos no representan bien la realidad, falla justo en lo que no ha visto. El caso extremo es el sobreajuste: el modelo rinde de maravilla con los datos de entrenamiento y mal con los nuevos. Google lo explica en su material sobre sobreajuste, donde subraya la importancia de evaluar con datos que el modelo no haya visto durante el entrenamiento.
Las etiquetas también las ponen personas, que se equivocan y pueden arrastrar prejuicios. Si los datos reflejan un trato desigual, el modelo puede aprenderlo y repetirlo. Es lo que IBM describe al hablar de sesgos en la IA. Hay más sobre este asunto en Riesgos de la inteligencia artificial: privacidad, sesgos y errores que conviene conocer.
En resumen, un buen resultado hay que comprobarlo: en el supervisado se mide con ejemplos cuya respuesta se conoce; en el no supervisado, con la revisión de personas que juzguen si los grupos tienen sentido.
Existen más enfoques: autosupervisado y por refuerzo
El mapa no se acaba en dos casillas. En el aprendizaje autosupervisado, el modelo fabrica sus propias «etiquetas» a partir de los datos, por ejemplo ocultando una parte de un texto para intentar adivinarla; IBM lo explica en su artículo sobre aprendizaje autosupervisado. En el aprendizaje por refuerzo, un sistema aprende actuando en un entorno, con recompensas cuando acierta y penalizaciones cuando falla. También existe el enfoque semisupervisado, con pocos datos etiquetados y muchos sin etiquetar. Por tanto, no todo el entrenamiento de los modelos modernos cabe en «supervisado» o «no supervisado».
Cómo se relacionan con las redes neuronales y la IA generativa
Una red neuronal es un tipo de modelo: una estructura de unidades conectadas. El aprendizaje supervisado y el no supervisado son formas de entrenarla, no tipos de red. Si quieres ver cómo funciona por dentro, tienes Neuronas reales y artificiales: cómo funcionan y cómo aprenden.
Los grandes modelos de lenguaje se entrenan en gran medida de forma autosupervisada: la «respuesta» sale del propio texto, al predecir fragmentos ocultos o siguientes (esos fragmentos son los tokens, de los que habla ¿Qué son los tokens en inteligencia artificial y por qué cuestan dinero?). Tanto IBM como la guía de Google sobre qué es el machine learning señalan que después pueden afinarse con datos supervisados o con refuerzo. El recorrido completo está en Cómo funciona la IA generativa: del entrenamiento a crear texto, imágenes y audio.
Ejercicio mental: ¿supervisado o no supervisado?
Decide en cada caso si el enfoque es supervisado o no supervisado:
- Predecir el precio de venta de un piso a partir de sus metros, su barrio y su antigüedad, usando miles de ventas anteriores.
- Agrupar canciones parecidas de una plataforma de música sin haber definido antes ningún género.
- Saber si una radiografía muestra algo anómalo, a partir de miles de imágenes que médicos ya han revisado.
- Agrupar las estaciones de bicicletas compartidas de una ciudad según su patrón de uso a lo largo del día.
- Estimar los minutos que tardará un reparto en llegar, a partir de repartos anteriores con su duración real.
Respuestas:
- Supervisado, regresión. Hay etiqueta (el precio real de ventas pasadas) y lo que se predice es un número.
- No supervisado, agrupación. No hay géneros previos que seguir. El algoritmo junta canciones por sus rasgos y una persona decide cómo llamar a cada grupo.
- Supervisado, clasificación. Las imágenes llevan la etiqueta «normal» o «anómala» puesta por especialistas, y el modelo aprende a distinguirlas. Requiere ese trabajo previo de revisión humana.
- No supervisado, agrupación. Nadie indicó de antemano qué tipos de estación existen, así que saldrán grupos que una persona tendrá que interpretar. Si ya vinieran marcadas como «de trabajo» o «de ocio», sería un problema supervisado.
- Supervisado, regresión. Cada reparto pasado trae su duración, y lo que se quiere estimar es una cantidad.
Para ampliar información
- Google, What is Machine Learning?
- Google, Supervised Learning
- Google, Introduction to clustering
- Google, Overfitting
- IBM, Supervised vs. Unsupervised Learning
- IBM, Types of Machine Learning
- IBM, What is Unsupervised Learning?
- IBM, What is Self-Supervised Learning?
- IBM, What is AI bias?
- scikit-learn, Clustering