Qué son los embeddings y cómo entiende la IA el significado de un texto
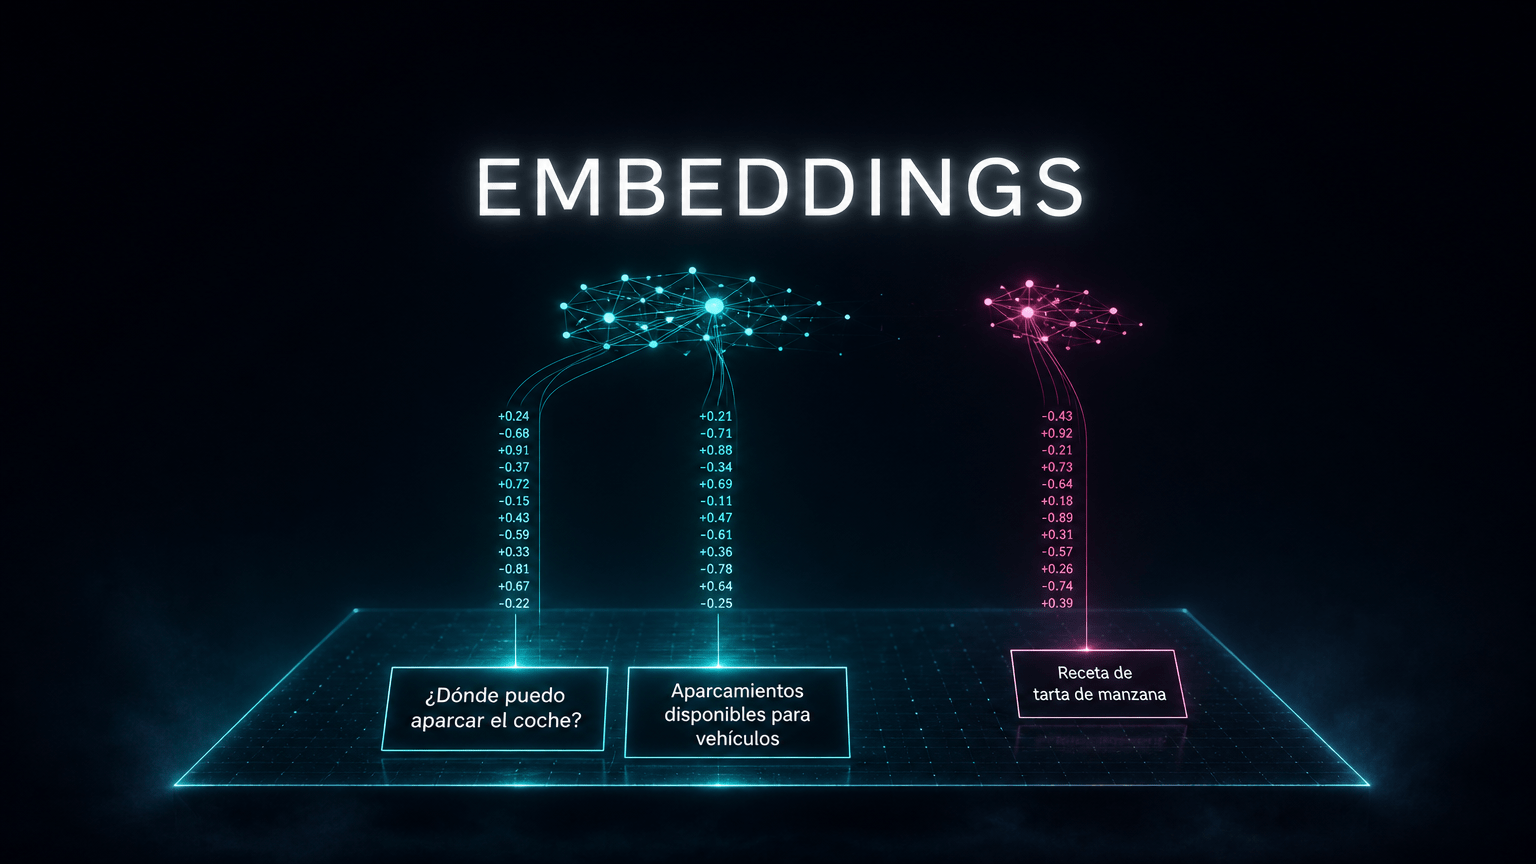
Si le preguntas a un buscador «¿dónde puedo aparcar el coche?» y te devuelve una página titulada «Aparcamientos disponibles para vehículos», has presenciado un pequeño truco. Las dos frases casi no comparten palabras, y aun así el sistema las ha relacionado. Detrás de ese truco hay una idea que aparece una y otra vez en la inteligencia artificial moderna: los embeddings.
Este artículo cierra la colección Fundamentos de la IA, y es un buen sitio para hacerlo, porque los embeddings conectan casi todo lo que hemos visto hasta ahora: tokens, Transformers, modelos de lenguaje y asistentes que responden con tus propios documentos. Si te preguntas qué son los embeddings, la respuesta corta es que son la forma en que una IA convierte un texto en números para poder compararlo con otros. La respuesta larga viene a continuación, sin fórmulas y con ejemplos de andar por casa.
Qué son los embeddings: significado convertido en números
Un embedding es una representación numérica de un contenido, normalmente un texto. En la documentación de OpenAI se describe como una lista de números en coma flotante (es decir, con decimales) que sirve para medir cuánto se relacionan dos textos: si la distancia entre dos listas es pequeña, los textos están muy relacionados; si es grande, lo están poco (OpenAI, guía de embeddings).
Esa lista de números se llama vector. Piensa en las coordenadas de un punto: «a 3 calles al este y 2 al norte» son dos números que sitúan un lugar en un plano. Un vector es lo mismo, pero con muchos más números, de modo que sitúa un texto en una especie de mapa abstracto. Un embedding, por tanto, es el punto que ocupa un texto en ese mapa.
¿Por qué hace falta todo esto? Porque un ordenador no lee como tú. Las letras, para él, son códigos sin significado propio, y comparar «coche» con «vehículo» letra a letra no le dice nada útil. Con números, en cambio, sí puede calcular distancias, ordenar resultados y comparar millones de textos en poco tiempo. Los embeddings son el puente entre el lenguaje humano y las matemáticas que maneja una máquina.
Conviene decirlo desde el principio: un embedding no contiene todo el significado de un texto. Es una representación útil, que capta ciertos aspectos de lo que se dice y deja otros fuera. Que sirva o no depende del modelo que lo genera, de los datos con que se entrenó y de la tarea para la que lo uses.
Tokens, embeddings, parámetros y ventana de contexto
Estos cuatro términos se mezclan con facilidad, así que vamos a separarlos:
- Los tokens son los fragmentos en que se trocea un texto antes de dárselo a un modelo: palabras enteras, trozos de palabra o signos. Ya los vimos en detalle en qué son los tokens y por qué cuestan dinero.
- Los embeddings son vectores que representan significado. Cada token, o cada texto completo, puede convertirse en uno.
- Los parámetros son los valores internos que el modelo ajustó durante su entrenamiento. Son el «conocimiento» aprendido, repartido en una cantidad enorme de números. No son el texto que le pasas, sino lo que el modelo es.
- La ventana de contexto es la cantidad de texto que cabe de una vez en una conversación o petición. Es, por así decirlo, el tamaño de la mesa de trabajo del modelo.
Una imagen para recordarlo: los tokens son las piezas, los embeddings dicen dónde se coloca cada pieza según su significado, los parámetros son lo que el modelo aprendió al entrenarse y la ventana de contexto es el tamaño de la mesa sobre la que cabe todo.
Embeddings, Transformers y LLM
Aquí hay un matiz que suele generar confusión. Los embeddings aparecen en dos papeles distintos.
Por un lado, un modelo generativo como los que explicamos en qué es un LLM y cómo funciona usa representaciones vectoriales por dentro: convierte los tokens en vectores y los va transformando capa a capa, gracias a la arquitectura que vimos en qué es un Transformer. Esas representaciones internas son un paso intermedio del cálculo; normalmente no las ves ni las guardas.
Por otro lado existen modelos especializados en búsqueda, como los de OpenAI o Google, cuya función es producir vectores pensados para compararse entre sí. Esos vectores sí se almacenan, normalmente en una base de datos vectorial, para recuperarlos más tarde.
Ambos usan la misma idea (significado como vector), pero no son lo mismo ni se emplean igual. De aquí en adelante, cuando hablemos de búsqueda, nos referimos al segundo caso.
Cuando dos textos están cerca: el mapa de similitud
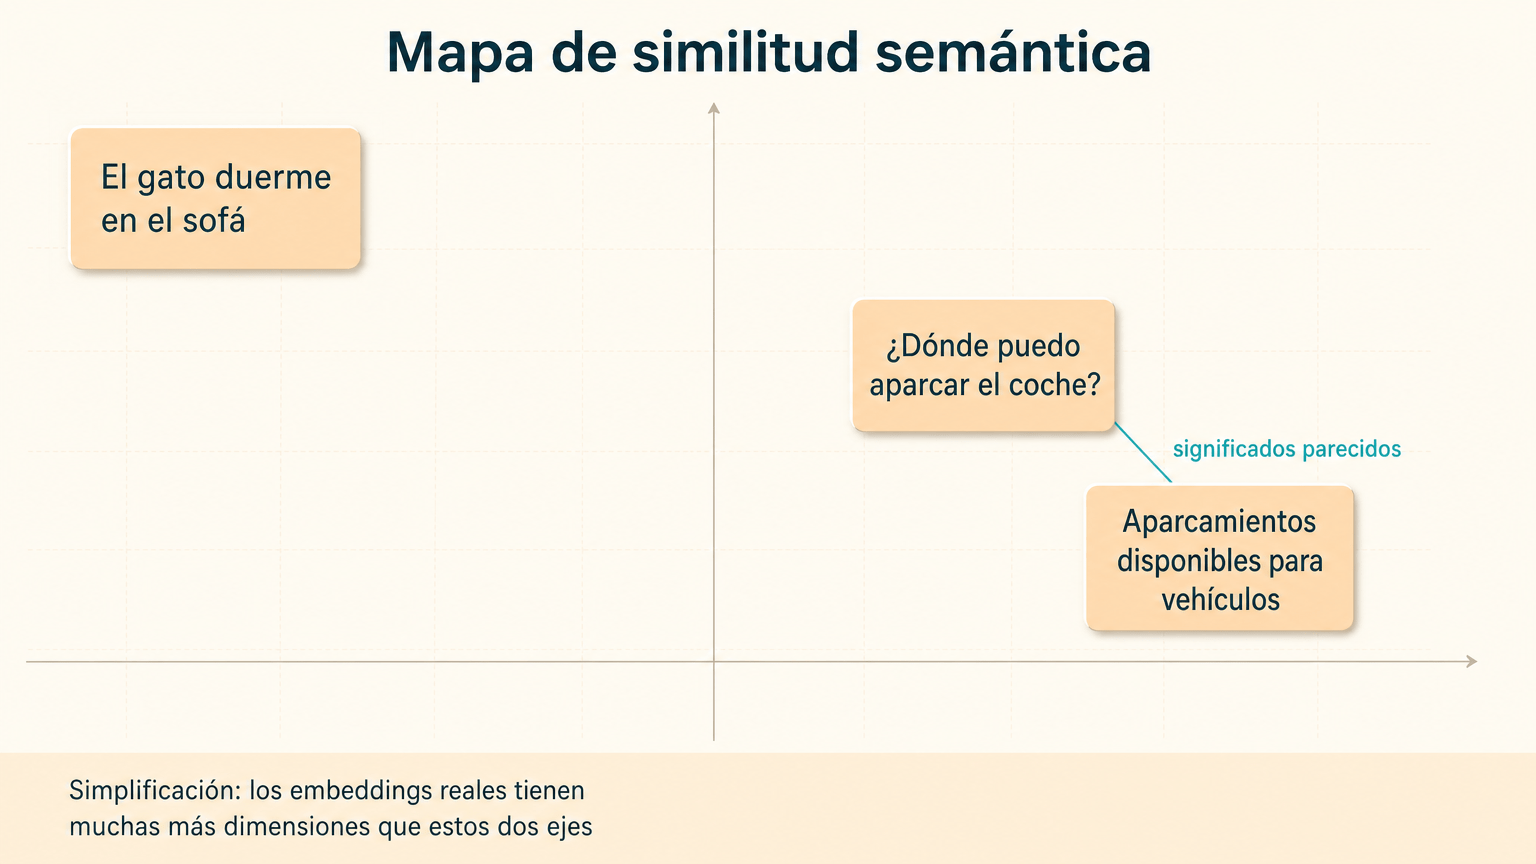
Pasemos a la parte visual. Imagina un mapa de relaciones, como un plano de ciudad donde las cosas parecidas se agrupan en el mismo barrio. Es solo una analogía, no cómo se guarda realmente la información, pero ayuda. Google lo expresa de forma parecida al describir el espacio de embeddings como un «mapa de los significados» (Google, búsqueda híbrida).
En ese mapa, conceptos como «gato», «perro» y «león» quedarían en un mismo barrio, y «coche», «camión» y «vehículo» en otro. Google cita justo esos grupos como ejemplo de conceptos que quedan próximos en el espacio de embeddings (Google BigQuery, introducción a los embeddings).
Ahora dibuja mentalmente un gráfico con dos ejes. En una esquina, un grupito de puntos: «aparcar el coche», «aparcamientos para vehículos», «plaza de garaje». En la esquina opuesta, otro grupito: «receta de lasaña», «cómo hacer bechamel». Un punto nuevo, «¿dónde dejo el coche?», caería junto al primer grupo y lejos del segundo. Eso es lo que significa que dos textos estén próximos en un espacio vectorial: sus vectores apuntan a zonas cercanas del mapa.
Y ahora, el aviso importante. Un gráfico de dos ejes es una simplificación para poder dibujarlo en una pantalla. Los vectores reales tienen cientos o miles de dimensiones, y esa riqueza extra es parte de lo que les permite captar matices. Además, la cercanía puede reflejar una relación semántica, pero no lo garantiza: dos vectores próximos no equivalen automáticamente a dos textos con el mismo significado.
Dos ejemplos: palabras distintas, mismo asunto; mismas palabras, asuntos distintos
Volvamos al ejemplo del principio. «¿Dónde puedo aparcar el coche?» y «Aparcamientos disponibles para vehículos» hablan de lo mismo, pero casi no comparten palabras (a lo sumo, la raíz de «aparcar»). Un sistema que solo busca coincidencias exactas tendría problemas para conectarlas. Uno basado en embeddings puede situarlas cerca, porque representa la intención y el tema, no solo las letras.
OpenAI ofrece un ejemplo muy claro. Con la consulta «When did we go to the moon?» («¿Cuándo fuimos a la Luna?»), el resultado más relevante es «The first lunar landing occurred in July of 1969» («El primer alunizaje ocurrió en julio de 1969»). Entre pregunta y respuesta no hay ni una sola palabra en común: la similitud por palabras clave es del 0 %, mientras que la similitud semántica calculada con un modelo de embeddings es del 65 % (OpenAI, guía de recuperación).
El caso contrario también existe. Fíjate en estas dos frases: «Me senté en el banco del parque a ver el río» y «Fui al banco a pedir una hipoteca». Comparten la palabra «banco», pero nada más. Una búsqueda por palabras clave las trataría como parientes; un buen modelo de embeddings, al tener en cuenta el contexto, tiende a colocarlas en barrios distintos del mapa. Conviene subrayar ese «tiende»: no es una garantía, y un modelo mediocre o poco entrenado en este tipo de ambigüedades puede equivocarse. Es el eterno drama del banco, que siempre acaba en mal sitio.
Búsqueda tradicional frente a búsqueda semántica
La búsqueda tradicional compara las palabras que escribes con las palabras que hay en los documentos. La búsqueda semántica compara significados representados como vectores. Un buscador puramente literal se parece a un bibliotecario muy aplicado pero muy literal: si no encuentra exactamente tu palabra en el título, te dice que no hay nada.
| Aspecto | Búsqueda por palabras clave | Búsqueda semántica |
|---|---|---|
| Qué compara | Las palabras exactas | Los significados representados como vectores |
| Ante sinónimos o paráfrasis | Suele fallar si no coinciden las palabras | Puede conectar textos con palabras distintas |
| Ante palabras ambiguas | Mezcla todos los sentidos | Puede distinguirlos según el contexto, sin garantía |
| Puntos fuertes | Nombres propios, códigos, cifras y términos exactos | Preguntas en lenguaje natural y búsquedas por tema |
| Punto débil | No «entiende» la intención | Puede acercar textos que solo se parecen en apariencia |
Ninguna es mejor en todo. Por eso existe la búsqueda híbrida, que combina ambas: Google la describe como la unión de la búsqueda semántica (embeddings densos) y la búsqueda por palabras clave (embeddings dispersos, con técnicas como TF-IDF, BM25 o SPLADE) (Google, búsqueda híbrida).
La similitud del coseno: medir si dos flechas apuntan al mismo sitio
Para saber si dos vectores están cerca hay varias medidas. La más habitual es la similitud del coseno, y OpenAI es una de las fuentes que la recomienda (OpenAI, guía de embeddings).
Sin cálculos, la idea es esta: imagina cada vector como una flecha que sale del mismo punto. La similitud del coseno no mira lo larga que es cada flecha, sino hacia dónde apunta. Si dos flechas apuntan casi en la misma dirección, el valor es alto; si apuntan en direcciones muy distintas, es bajo. Es como dos personas señalando con el dedo: lo que importa es si miran al mismo sitio, no lo largo que tengan el brazo.
OpenAI añade un detalle técnico curioso: sus embeddings vienen normalizados a longitud 1, es decir, todas las «flechas» miden lo mismo. Por eso la similitud del coseno y la distancia euclídea (la distancia «en línea recta») ordenan los resultados exactamente igual.
Dimensiones: por qué los dibujos de dos ejes se quedan cortos
Cada número del vector es una dimensión. En un plano hay dos; en el espacio, tres. Los embeddings reales usan muchísimas más. Por defecto, dos modelos de embeddings de OpenAI producen vectores de 1.536 y de 3.072 dimensiones, y esa cifra puede reducirse sin que el vector pierda del todo su capacidad de representar conceptos (OpenAI, guía de embeddings). Google habla igualmente de «vectores numéricos de alta dimensión».
No podemos visualizar 1.536 ejes, pero ayuda pensar que cada dimensión recoge algún rasgo sutil, aunque normalmente no se corresponde con algo que un humano sepa nombrar (como «es un animal» o «es formal»). Son patrones que el modelo descubre durante su entrenamiento. Más dimensiones permiten distinguir más matices, a costa de ocupar más espacio y de requerir más cálculo.
Cómo se generan los embeddings de consultas y documentos
Para que una búsqueda semántica funcione hacen falta dos tipos de vectores.
Primero, el de los documentos: se procesan una sola vez, antes de que nadie pregunte nada, y su vector se guarda. Segundo, el de la consulta: cada vez que alguien pregunta, su pregunta se convierte en un vector en el momento. Lo habitual es usar el mismo modelo para ambos, de forma que pregunta y documentos queden en el mismo mapa y se puedan comparar.
Por qué importa trocear los documentos en chunks
Un documento largo no suele convertirse en un único vector. Se divide en fragmentos llamados chunks (en inglés, «trozos»). OpenAI lo describe así: cuando se añade un archivo a un almacén vectorial, este se divide en fragmentos, se vectoriza y se indexa automáticamente (OpenAI, guía de recuperación).
La forma de trocear influye mucho en la calidad. Si los fragmentos son demasiado grandes, un mismo vector mezcla varios temas y se vuelve confuso. Si son demasiado pequeños, pierden el contexto y una frase suelta puede significar otra cosa. No hay una medida universal: depende del tipo de documento y de las preguntas esperadas, y por eso se prueba y se ajusta.
Bases de datos vectoriales: el archivo que ordena por significado
Una base de datos vectorial es un sistema diseñado para guardar vectores y, sobre todo, para encontrar rápido los más cercanos a uno dado. Una base de datos tradicional responde bien a «dame los clientes de Valencia»; una vectorial responde a «dame los textos más parecidos a este».
Aquí hay un compromiso interesante. La búsqueda exacta comparando la consulta con todos los vectores (llamada «fuerza bruta») da resultados exactos, pero se vuelve lenta cuando hay muchos datos. Con un índice vectorial se usa una búsqueda aproximada de vecinos más cercanos, que gana velocidad a cambio de ser algo menos exhaustiva, es decir, puede dejarse algún resultado relevante (Google BigQuery, búsqueda vectorial). Ese tipo de búsqueda vectorial es el que sustenta productos de Google como Search, YouTube o Play.
Recorrido paso a paso de una búsqueda semántica
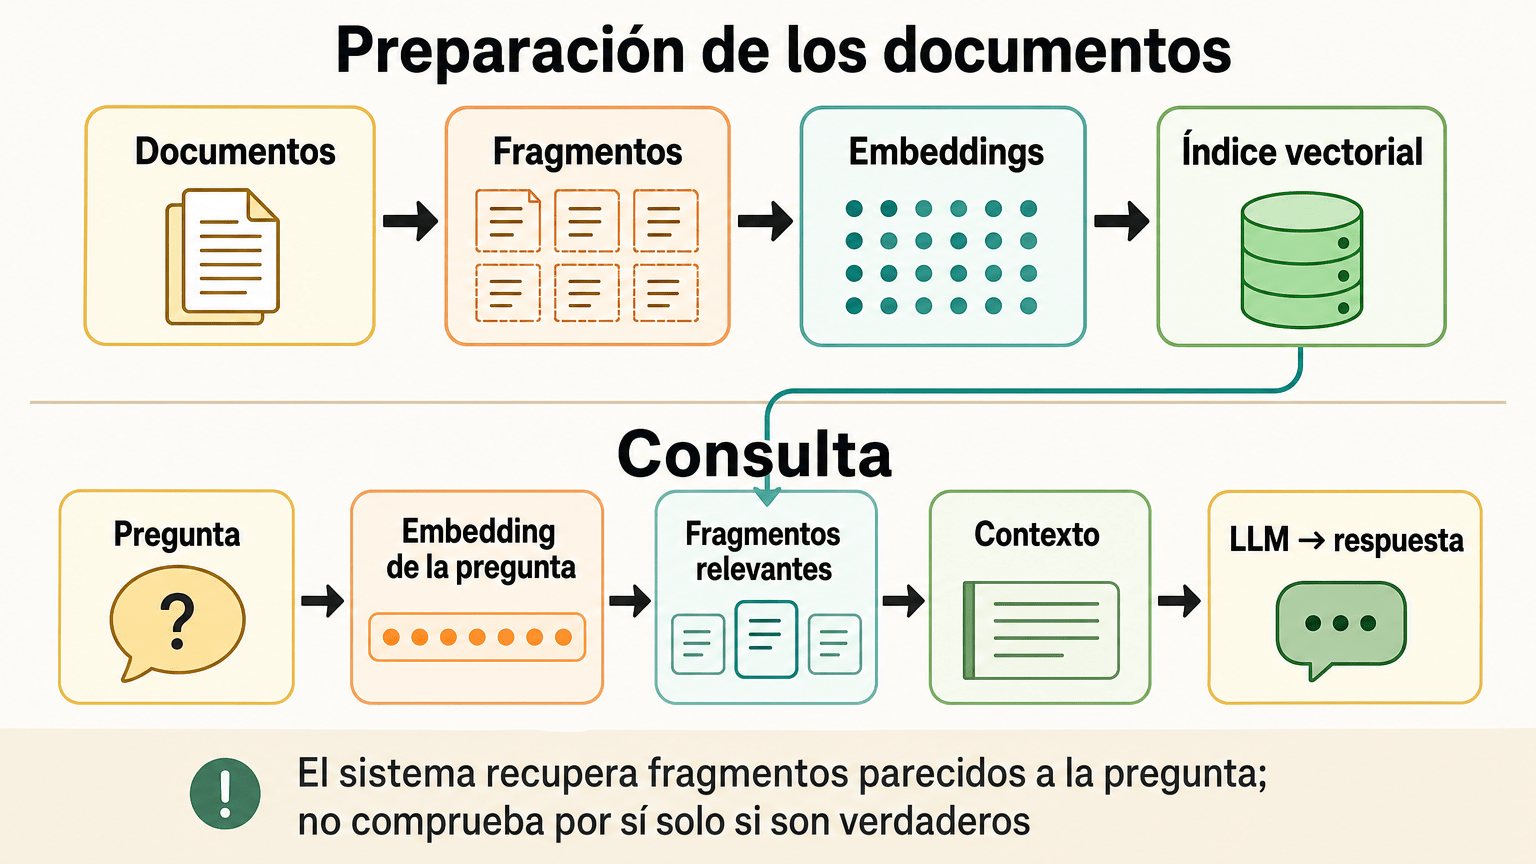
Reunamos las piezas. Esto ocurre cuando haces una búsqueda semántica:
- Antes de nada, los documentos se dividen en chunks, se convierten en vectores y se guardan en una base vectorial.
- Escribes una pregunta.
- La pregunta se convierte en un embedding con el mismo tipo de modelo.
- La base vectorial busca los vectores más cercanos al de la pregunta, usando una medida como la similitud del coseno.
- Te devuelve los fragmentos correspondientes, ordenados de más a menos próximos.
Fíjate en que hasta aquí no se ha generado ninguna respuesta nueva: el sistema solo ha recuperado textos que ya existían.
RAG: recuperar primero, generar después
RAG (Retrieval-Augmented Generation, o generación aumentada por recuperación) añade un paso más: entrega esos fragmentos recuperados a un modelo generativo para que redacte la respuesta apoyándose en ellos. La propuesta original, de Lewis y sus colaboradores en 2020, combina la memoria paramétrica (un modelo generativo ya entrenado) con una memoria no paramétrica (un índice vectorial denso de Wikipedia al que se accede con un recuperador), de modo que el modelo genera respuestas apoyadas en documentos recuperados sin reentrenar el generador (Lewis et al., 2020).
Un ejemplo conceptual: el asistente de una empresa
Imagina una empresa con cientos de documentos internos: manuales, procedimientos, preguntas habituales de personal. Quiere un asistente que responda dudas de los empleados, y no quiere reentrenar un modelo de lenguaje, que es costoso y complejo. Con RAG, los documentos ya están troceados y guardados como vectores; un empleado pregunta, por ejemplo, «¿Con cuánta antelación debo avisar para pedir una excedencia?»; su pregunta se convierte en un vector y la base vectorial recupera los pasajes del reglamento interno sobre excedencias, aunque no usen esas palabras exactas. Esos fragmentos se entregan al modelo generativo junto con la pregunta, dentro de su ventana de contexto, y el modelo redacta una respuesta apoyada en ellos, indicando idealmente de dónde salen.
Si mañana cambia el reglamento, basta con actualizar los documentos y sus vectores: el modelo no hay que reentrenarlo. Un caso práctico parecido, aplicado a tus propios archivos, lo contamos en cómo hablar con tus PDF utilizando una IA local.
Otros usos de los embeddings
La búsqueda no es el único terreno donde se usan:
- Recomendaciones: si dos contenidos o dos usuarios están cerca en el mapa, tiene sentido sugerir algo parecido.
- Agrupación de textos: reunir de forma automática opiniones, correos o noticias que tratan del mismo tema.
- Clasificación: usar el vector como punto de partida para asignar categorías, como «consulta de facturación» o «incidencia técnica».
- Detección de duplicados: localizar textos casi idénticos aunque estén redactados de forma distinta.
- Búsqueda multimodal: los embeddings no son exclusivos del texto. Google los genera también para imagen, vídeo y audio, y admite embeddings multimodales, que permiten, por ejemplo, buscar imágenes a partir de una descripción escrita (Google BigQuery, introducción a los embeddings).
Limitaciones: cuándo fallan los embeddings
Que una tecnología sea útil no significa que sea infalible. Hay varios puntos débiles que conviene tener presentes:
- Errores de similitud: dos textos pueden quedar cerca sin ser equivalentes, o lejos siendo relevantes. La cercanía es una pista, no una prueba.
- Ambigüedad: las palabras con varios sentidos, o las frases dependientes del contexto, pueden confundir al modelo.
- Sesgos: el modelo aprende de los textos con los que se entrenó, y puede reproducir sus sesgos.
- Idioma: el rendimiento puede variar entre idiomas según los datos con los que se haya entrenado el modelo, así que conviene comprobarlo en el que tú usas.
- Información desactualizada: los modelos tienen fecha de corte. Dos modelos de embeddings de OpenAI, por ejemplo, no conocen hechos posteriores a septiembre de 2021, lo que en algunos casos reduce su rendimiento (OpenAI, guía de embeddings).
- Necesidad de evaluar: no basta con que parezca que funciona. Hay que probar con preguntas reales, revisar qué fragmentos se recuperan y comprobar si son los adecuados.
Privacidad y seguridad: un vector no es un disfraz
Existe la tentación de pensar que, al convertir un texto en una lista de números ilegible, los datos quedan anonimizados. No es así. Un trabajo de investigación llamado Vec2Text consiguió reconstruir exactamente el 92 % de textos de 32 tokens a partir de sus embeddings, y llegó a recuperar nombres completos en notas clínicas. Sus autores concluyen que los embeddings deben tratarse como datos privados de alta sensibilidad, protegidos igual que se protegería el texto original (Morris et al., 2023).
En la práctica, esto significa que tanto los embeddings como las bases vectoriales que los almacenan pueden contener o revelar información sensible. Si tus documentos son confidenciales, sus vectores también lo son, y merecen el mismo cuidado en accesos, almacenamiento y permisos.
Búsqueda semántica y alucinaciones: lo que RAG sí y no puede hacer
La búsqueda semántica devuelve lo más parecido, no lo verdadero. Si un documento contiene un error, o si los fragmentos recuperados no son los adecuados, el sistema los presentará igual. Y el modelo generativo que redacta la respuesta puede interpretar mal lo recuperado, mezclarlo con lo que ya «sabía» o añadir algo que no estaba.
Por eso, RAG puede reducir determinadas alucinaciones, sobre todo las que surgen cuando el modelo carece de información concreta, porque le da material sobre el que apoyarse. Pero no las elimina. Lo prudente es pedir que cite sus fuentes, revisar los pasajes en que se basa y verificar los datos importantes.
Preguntas frecuentes sobre los embeddings
¿Un embedding es lo mismo que un token?
No. El token es un fragmento de texto; el embedding es un vector que representa significado. Un token puede convertirse en un embedding, pero no son lo mismo.
¿La IA entiende el texto como una persona?
No. Los embeddings capturan patrones estadísticos del lenguaje que resultan muy útiles para comparar textos, pero eso no equivale a comprender como lo hace un ser humano.
¿Hay que reentrenar el modelo para que use mis documentos?
No necesariamente. Con RAG, los documentos se guardan como vectores en una base y el modelo los recibe como contexto cuando hace falta, sin modificar el modelo.
¿Convertir datos en vectores los anonimiza?
No. Las investigaciones han mostrado que pueden reconstruirse textos a partir de sus embeddings, así que conviene protegerlos como datos sensibles.
¿RAG evita que la IA se invente cosas?
Puede reducir algunas alucinaciones, pero no las elimina. Sigue siendo necesario revisar las respuestas y las fuentes.
¿Los embeddings solo sirven para texto?
No. También se generan para imágenes, vídeo y audio, y permiten, por ejemplo, la búsqueda multimodal.
Lo que cierra la colección
Los embeddings son una pieza discreta pero esencial: convierten el significado en geometría, y gracias a eso una IA puede buscar, agrupar, recomendar o apoyar sus respuestas en documentos concretos. Ni son magia ni son una garantía de verdad, y entender sus límites es lo que permite usarlos bien.
Si has llegado hasta aquí desde el principio de la colección, el recorrido completo empieza en qué es la inteligencia artificial. Y si algo de este artículo te ha dejado con ganas de más, lo mejor es echar un vistazo a las fuentes del final.
Para ampliar información
- OpenAI: Vector embeddings
- OpenAI: Retrieval (búsqueda semántica y vector stores)
- Google BigQuery: Introduction to embeddings and vector search
- Google BigQuery: Search embeddings with vector search
- Google Vertex AI: About hybrid search
- Google: Machine Learning Crash Course, Embeddings
- Lewis et al. (2020): Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Morris et al. (2023): Text Embeddings Reveal (Almost) As Much As Text