Qué es un Transformer: la arquitectura que revolucionó la inteligencia artificial
Si has oído hablar de la inteligencia artificial en los últimos años, has oído hablar, sin saberlo, de los Transformers. Están detrás de los traductores automáticos, de muchos buscadores y de los asistentes que escriben texto. Y no, no tienen nada que ver con camiones que se convierten en robots gigantes. Aunque el nombre invita a imaginarlo, la realidad es más modesta y bastante más interesante.
Qué es un Transformer (y qué no es)
Un Transformer es una arquitectura: un plano de construcción para diseñar redes neuronales. Una red neuronal es un sistema de cálculo formado por muchas piezas sencillas conectadas entre sí, que aprende ajustando esas conexiones. Si quieres repasar cómo encaja esto con el resto de conceptos, lo explicamos en IA, machine learning y deep learning: diferencias con ejemplos.
Por eso conviene separar tres cosas que se mezclan a menudo:
- El Transformer es el plano, la idea de cómo organizar el cálculo.
- Un modelo es una red concreta construida con ese plano y entrenada con datos.
- Un producto, como un asistente conversacional, es una aplicación que usa uno o varios modelos y añade interfaz, ajustes y otros componentes.
Decir que ChatGPT «es un Transformer» sería como decir que un coche «es un motor de combustión»: el motor es una pieza clave, pero no es el coche, y menos aún el servicio de transporte.
El problema: leer palabra a palabra
Antes de 2017, una de las herramientas habituales para trabajar con texto eran las redes recurrentes (RNN). Procesan el lenguaje en secuencia, palabra a palabra, de izquierda a derecha o al revés, y van arrastrando una especie de resumen de lo leído hasta ese momento.
Según el blog de investigación de Google, esto trae dos problemas. El primero es que, para tomar decisiones que dependen de palabras muy alejadas entre sí, la red necesita muchos pasos, y cuanto más pasos, más difícil le resulta aprender esas relaciones. IBM lo resume diciendo que las RNN son intrínsecamente serializadas, lo que limita su capacidad de capturar dependencias de largo alcance. Las variantes LSTM lo paliaron en parte, pero el problema de fondo siguió ahí.
El segundo problema es práctico: ese avance de uno en uno desaprovecha el hardware moderno (GPU y TPU, procesadores especializados en hacer muchísimos cálculos a la vez).
Las redes convolucionales (CNN) son menos secuenciales, pero, según el mismo blog, en arquitecturas como ByteNet o ConvS2S el número de pasos para combinar información lejana sigue creciendo con la distancia.
| Aspecto | Modelos recurrentes (RNN) | Transformers |
|---|---|---|
| Cómo leen | En general, elemento a elemento y en orden | Relacionan todos los elementos de la secuencia mediante autoatención |
| Relaciones entre palabras lejanas | Suelen requerir muchos pasos intermedios | Pueden conectarse directamente, con un número pequeño y constante de pasos |
| Entrenamiento | Su carácter secuencial limita el paralelismo | Con la secuencia completa disponible, se calcula en paralelo para todas las posiciones |
| Aprovechamiento del hardware | Menor | Mayor, según los autores del trabajo original |
| Coste con textos muy largos | Limitado sobre todo por la lectura en serie | Crece con el cuadrado de la longitud del contexto |
La tabla recoge tendencias generales, no leyes absolutas.
2017: «Attention Is All You Need»
El 12 de junio de 2017, ocho investigadores que entonces trabajaban en Google (Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser e Illia Polosukhin) enviaron a arXiv el artículo «Attention Is All You Need». Se presentó ese mismo año en la conferencia NeurIPS.
Su propuesta, en palabras del resumen, era una arquitectura basada únicamente en mecanismos de atención, que prescinde por completo de la recurrencia y de las convoluciones. Los modelos resultantes eran, según los autores, superiores en calidad, más paralelizables y mucho más rápidos de entrenar. Para demostrarlo dieron cifras de traducción automática: 28,4 puntos BLEU (una puntuación habitual para evaluar traducciones) del inglés al alemán y 41,8 del inglés al francés, tras 3,5 días de entrenamiento en ocho GPU, una fracción del coste de los mejores modelos conocidos entonces. También lo aplicaron con éxito al análisis sintáctico, que consiste en descomponer la estructura gramatical de una frase.
Conviene tener claro qué no era aquel trabajo. No describía asistentes conversacionales, ni ajuste por instrucciones, ni «inteligencia» alguna. Era un artículo de traducción automática y análisis gramatical. Todo lo demás vino después.
Qué significa «prestar atención»
En este contexto, atención es un mecanismo de cálculo: para cada elemento de un texto, el modelo calcula cuánto debe influir cada uno de los demás elementos en su interpretación. Esa influencia se expresa con números llamados pesos. No hay concentración, ni intención, ni comprensión humana: hay un reparto numérico de importancia.
Cuando ese reparto se hace dentro de la propia secuencia de entrada, se habla de autoatención. Google lo formula así en su curso de machine learning: para cada token, ¿cuánto afecta cada uno de los demás a su interpretación? (Un token es cada fragmento de texto con el que trabaja el modelo; lo vemos en detalle unas líneas más abajo).
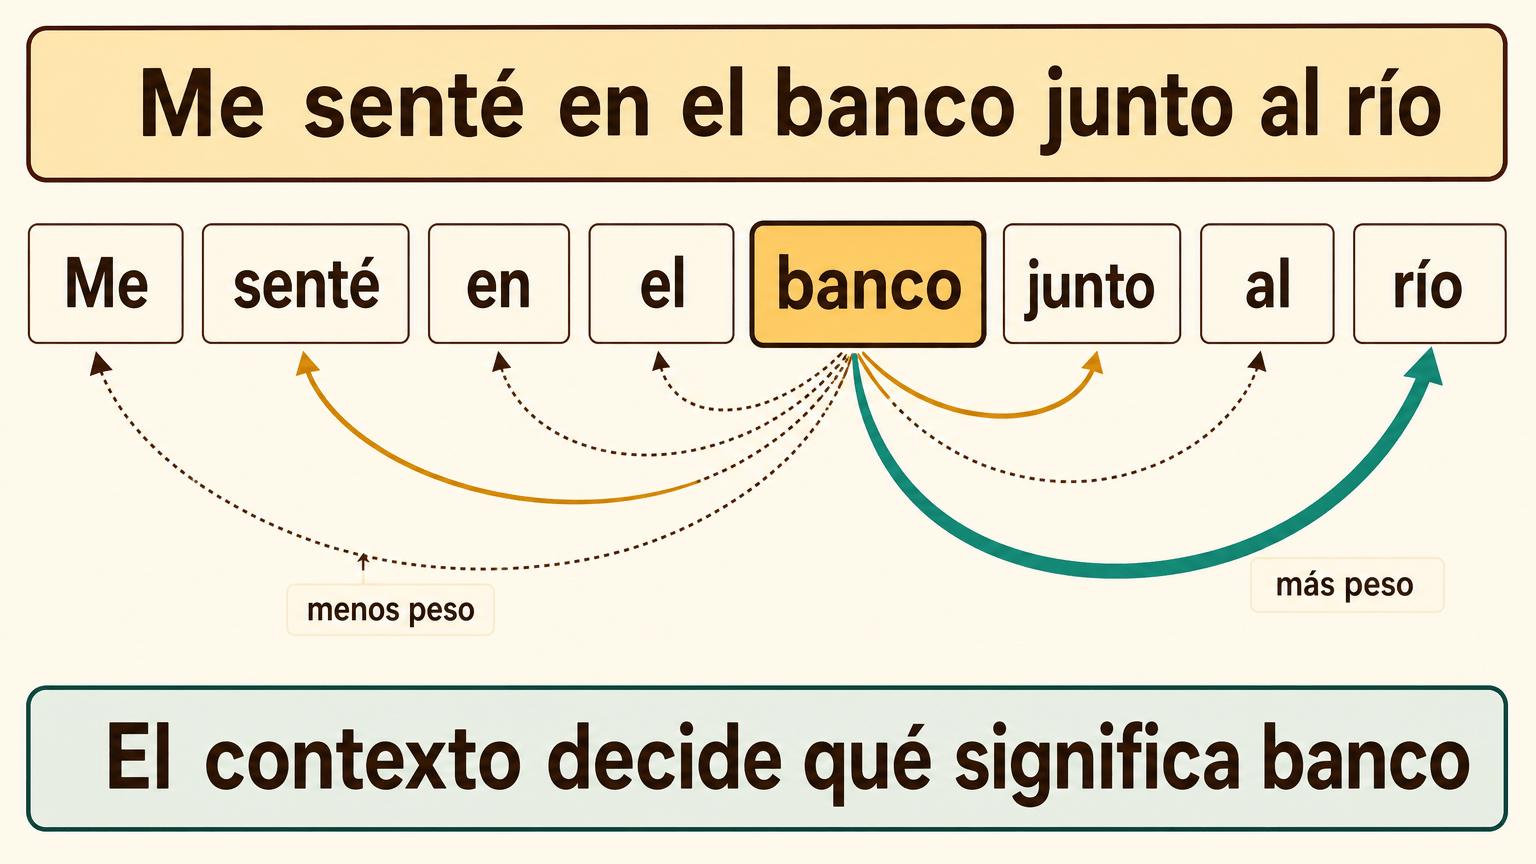
Veamos un ejemplo cotidiano, una adaptación libre del que usa el blog de Google con la palabra inglesa «bank»: «Crucé el río y me senté en el banco». La palabra «banco» puede ser un asiento o una entidad financiera. Para saber cuál, el modelo necesita relacionarla con «río», que está unas cuantas palabras más atrás. El blog señala que el Transformer puede atender directamente a esa palabra y resolverlo en un solo paso, sin recorrer una a una las intermedias.
Otro ejemplo canónico de las fuentes técnicas es «The animal didn’t cross the street because it was too tired»: el pronombre «it» se relaciona sobre todo con «animal». Si la frase acaba en «…because it was too wide» (demasiado ancha), lo relevante pasa a ser «street».
La analogía de la mesa de mezclas. Imagina que cada palabra es un técnico de sonido frente a una mesa con un deslizador por cada una de las demás palabras de la frase. Para decidir qué significa «banco», sube el volumen de «río» y de «senté» y baja el de «y» o «el». El resultado es una mezcla en la que «banco» suena ya con el contexto incorporado. Es solo una analogía: en el modelo no hay mesas ni oídos, solo números. Pero ayuda a ver la idea de un volumen distinto para cada relación.
De palabras a números: tokens, embeddings y posición
Un modelo no lee letras como nosotros: trabaja con números. Primero el texto se trocea en tokens, fragmentos que pueden ser una palabra entera, un trozo de palabra o un signo de puntuación. Si te preguntas por qué se cuentan y por qué cuestan dinero, lo desarrollamos en qué son los tokens en inteligencia artificial.
Después, cada token se convierte en un embedding: una lista de números que lo representa de forma que el modelo pueda compararlo con otros. Es la representación de partida y se va refinando por el camino. De los embeddings hablaremos con calma en el siguiente artículo de la serie.
Falta una pieza. Si el modelo recibiera todos los tokens a la vez sin más, no sabría en qué orden iban, y «el perro muerde al hombre» sería lo mismo que «el hombre muerde al perro». Por eso se añade a cada token información posicional, un dato sobre el lugar que ocupa en la secuencia.
Query, Key y Value: la analogía de la biblioteca
Las fuentes técnicas explican la atención con tres piezas llamadas «query», «key» y «value» (consulta, clave y valor). IBM las presenta con el símil de una base de datos, que podemos trasladar a una biblioteca:
- La query es la pregunta que lleva cada token: lo que «busca».
- La key es la etiqueta del lomo de cada libro: la información que cada token ofrece para que lo encuentren.
- El value es el contenido del libro: lo que se devuelve cuando la búsqueda encaja, en mayor o menor medida.
Si una pregunta encaja bien con una etiqueta, ese libro pesa más en la respuesta final. Conviene recordarlo: es una analogía, no una descripción literal de las operaciones internas. En el modelo no hay bibliotecarios; hay números que se comparan, se convierten en pesos y se combinan.
El mecanismo, resumido en cuatro pasos: se convierte la secuencia en vectores (listas de números); se compara cada vector con los demás para obtener puntuaciones; se transforman en pesos de atención normalizados entre 0 y 1; y se usan esos pesos para dar más o menos importancia a cada elemento.
Atención multicabeza: varias miradas a la vez
Una frase contiene relaciones de muchos tipos: quién hace qué, a qué sustantivo se refiere un pronombre, qué adjetivo califica a qué nombre. Por eso, cada capa de autoatención suele tener varias cabezas, es decir, varios mecanismos de atención que trabajan a la vez sobre la misma secuencia.
Como cada cabeza arranca de parámetros iniciales distintos (los valores numéricos internos que el modelo ajusta durante el entrenamiento), puede acabar especializándose en relaciones diferentes. Según Google, una puede fijarse en a qué sustantivo se refiere un pronombre y otra en las relaciones gramaticales. La salida de la capa combina todas las cabezas. En el Transformer original, el blog muestra una de las ocho cabezas de atención al representar el pronombre «it».
Codificador, decodificador y las dos mezclas
No todos los Transformers tienen la misma configuración. Hay dos bloques básicos:
- El codificador lee la entrada completa y la convierte en una representación intermedia.
- El decodificador genera la salida palabra a palabra, consultando esa representación y lo que ya ha generado.
De ahí salen tres familias:
- Codificador y decodificador (el diseño original de 2017, pensado para traducir).
- Solo codificador, como BERT (2019). Sirve para clasificar textos o crear embeddings que alimentan otros sistemas. IBM lo vincula con muchas aplicaciones de embeddings y con la búsqueda de Google.
- Solo decodificador, como los modelos tipo GPT, que generan texto nuevo a partir de lo anterior.
Hay además una diferencia sutil: la autoatención del codificador es bidireccional (mira lo que hay antes y después de cada token), mientras que la del decodificador es unidireccional, porque al generar solo puede apoyarse en lo ya producido.
Capas: refinar paso a paso
Una capa es una etapa de procesamiento que recibe representaciones y devuelve otras más elaboradas. En un Transformer se apilan varias, y la salida de cada una es la entrada de la siguiente. Según Google, las primeras tienden a captar la sintaxis básica y las más profundas integran esa información en nociones más abstractas. Es un refinado progresivo, como pulir una piedra con lijas cada vez más finas.
El recorrido completo, paso a paso
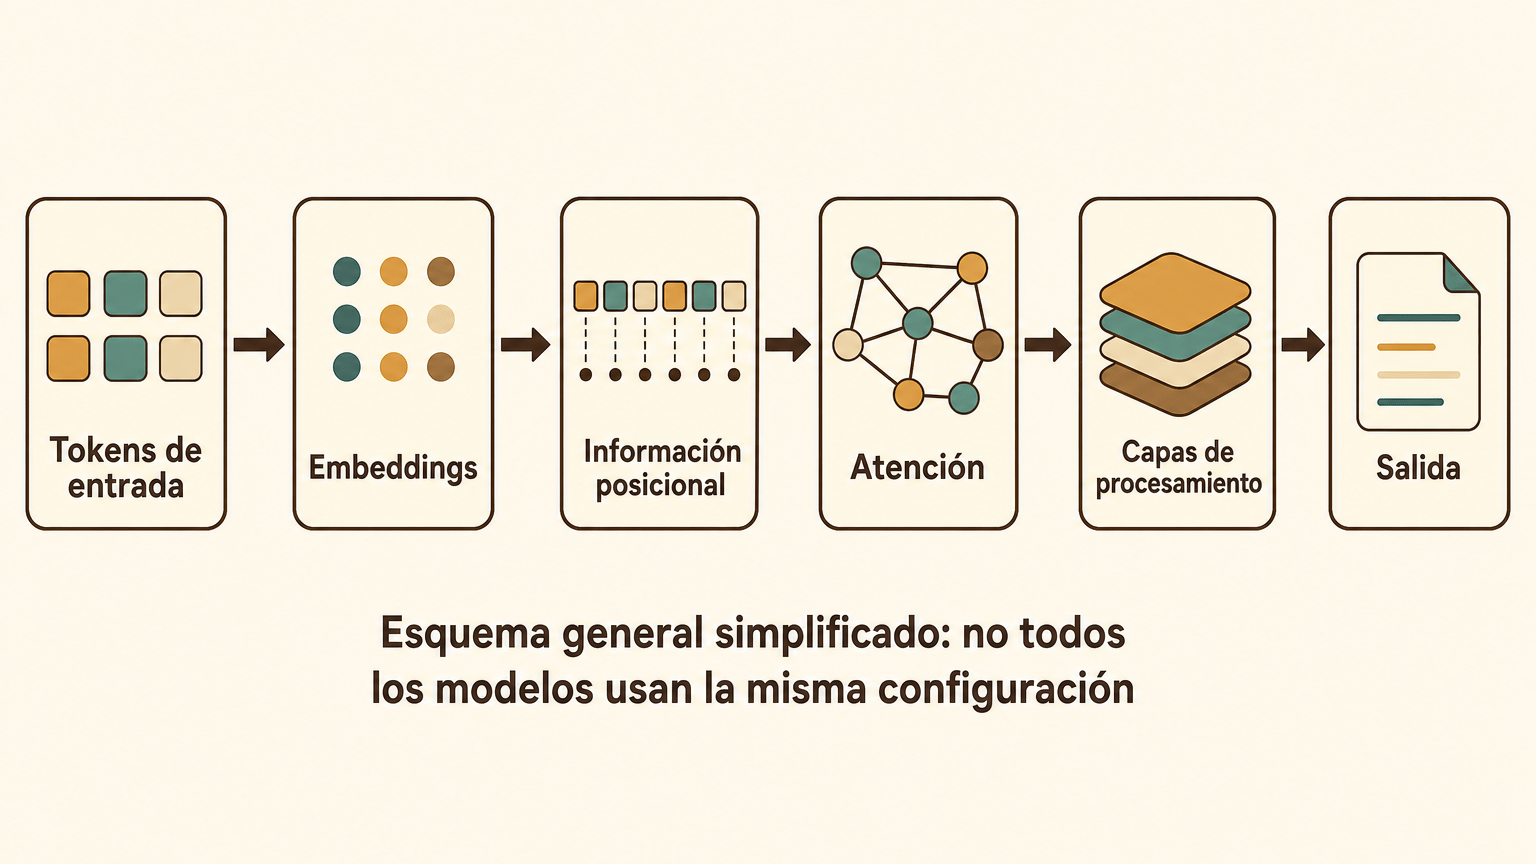
Sigamos «Me senté en el banco junto al río» de principio a fin. Algunos pasos están simplificados; los señalo.
- Troceado. El texto se divide en tokens. «Simplificación:» aquí imaginamos un token por palabra, pero en la práctica un token puede ser parte de una palabra.
- Embeddings. Cada token se convierte en una lista de números.
- Posición. Se añade a cada uno la información de su lugar en la frase.
- Atención. Cada token se compara con todos los demás y recibe pesos. «Banco» daría bastante peso a «río». «Simplificación:» es una ilustración, no la medición de un modelo real.
- Mezcla. Con esos pesos se calcula una nueva representación de cada token, ya informada por el contexto.
- Repetición en capas. El proceso se repite varias veces, afinando las representaciones.
- Salida. Según la configuración, el resultado puede ser una traducción, una clasificación o la predicción del siguiente token.
Paralelo en el entrenamiento, secuencial al generar
Aquí hay un matiz importante. Durante determinadas fases del entrenamiento, cuando el modelo dispone de la secuencia completa, el cálculo puede hacerse para todas las posiciones a la vez, según el blog de Google. Esto encaja muy bien con las GPU y explica que el trabajo de 2017 hablara de menor tiempo de entrenamiento. El blog cita aceleraciones de hasta un orden de magnitud (aproximadamente, diez veces).
Pero no significa que todo ocurra en paralelo. Al generar texto, un decodificador produce una palabra cada vez, de izquierda a derecha, atendiendo a las anteriores. Dentro de cada paso se hacen cálculos masivos en paralelo, pero el texto va saliendo token a token.
Transformers, LLM y generación de texto
Un modelo de lenguaje de gran tamaño (LLM) funciona, en esencia, como un mecanismo de autocompletado: dada una secuencia, predice el siguiente token, lo añade y repite. Lo cuentan Google y nosotros en ¿Qué es un LLM y cómo funciona?.
Ahora bien, la arquitectura no lo explica todo. Los resultados de un LLM dependen también de los datos de entrenamiento y de su volumen, del ajuste posterior y de otros componentes. El entrenamiento típico comienza con una fase autosupervisada (el modelo aprende a predecir tokens ocultos en textos, sin etiquetas humanas; en aprendizaje supervisado y no supervisado tienes el contexto). Después puede haber un ajuste por instrucciones.
Todo eso es posterior a 2017: BERT llegó en 2019, los modelos de solo decodificador tipo GPT abrieron la era generativa, y los asistentes conversacionales vinieron más tarde. Si quieres ver cómo encaja en el proceso completo, repasa cómo funciona la IA generativa.
Para qué se usan
Los propios autores ya señalaban que la arquitectura podía ir más allá del texto. Hoy, según las fuentes, se usa en:
- Traducción automática, su caso de origen.
- Búsqueda y clasificación de textos, a menudo mediante embeddings.
- Imagen: los «vision transformers» dividen una imagen en parches. IBM da el ejemplo de una imagen de 224×224 píxeles repartida en 256 parches de 14×14.
- Audio y voz, series temporales y modelos multimodales, que combinan varios tipos de datos. IBM añade que también muchos modelos de difusión para generar imágenes los emplean.
En programación también se usan estos modelos: los asistentes que completan código parten de la misma idea de fondo —texto convertido en tokens que se predicen uno tras otro—, aunque se entrenan y se ajustan de forma específica para ese trabajo.
Limitaciones
- Cómputo. La autoatención obliga a cada token a relacionarse con todos los demás, así que su coste crece con el cuadrado del número de tokens del contexto. Duplicar la longitud no duplica el trabajo: lo multiplica por cuatro.
- Recursos. Google enumera además el enorme consumo de electricidad entre los problemas de estos modelos.
- Dependencia de los datos. Un modelo refleja lo que ha visto al entrenarse, incluidos sus sesgos.
- Alucinaciones. Pueden generar texto plausible pero falso.
- Contextos largos. Su coste es un problema activo y reconocido.
¿Hay alternativas?
Sí. Un trabajo de 2023 sobre Mamba reconoce que los modelos fundacionales actuales se basan «casi universalmente» en Transformers, pero recuerda que existen alternativas como la atención lineal, los modelos recurrentes o los modelos de espacio de estados. Mamba, según sus autores, escala de forma lineal con la longitud de la secuencia y logra hasta cinco veces más rendimiento en inferencia que los Transformers. Son resultados de sus creadores, no un veredicto independiente. Lo prudente es decir que el Transformer domina, pero no es la única arquitectura ni garantiza el futuro.
Preguntas frecuentes
¿Transformer y ChatGPT son lo mismo?
No. El Transformer es una arquitectura; ChatGPT es un producto que usa modelos de lenguaje y añade ajustes, interfaz y otros componentes.
¿Prestar atención significa que el modelo comprende?
No. La atención es un reparto numérico de pesos entre representaciones, no conciencia, intención ni comprensión humana.
¿Todos los Transformers generan texto?
No. Los de solo codificador, como BERT, sirven sobre todo para clasificar o crear embeddings. Generan texto los de solo decodificador o los que combinan ambas partes.
¿Si el entrenamiento es paralelo, la generación también?
No del todo. El texto se genera token a token, aunque cada paso implique muchos cálculos simultáneos.
¿Toda la IA actual es un Transformer?
No. Dominan muchos modelos, pero existen alternativas como Mamba y otras familias.
Para ampliar información
- Vaswani et al., «Attention Is All You Need», versión oficial de NeurIPS 2017.
- LedSolEo: Neuronas reales y artificiales: cómo funcionan y cómo aprenden.
- LedSolEo: Historia de la inteligencia artificial: del nacimiento de una idea a la IA generativa.
- LedSolEo: Qué es la inteligencia artificial: explicación sencilla con ejemplos cotidianos.