¿Qué son los tokens en inteligencia artificial y por qué cuestan dinero?
Un token es un trozo de texto, no una palabra
Cuando escribes a un chatbot, este no recibe tu frase entera. Imagina una caja de piezas de construcción: antes de montar nada, el texto se separa en piezas pequeñas. Cada trozo es un token, la unidad con la que trabaja el modelo y con la que se calcula la factura. Si quieres empezar más atrás, tienes qué es la inteligencia artificial.
Por qué un token no equivale a una palabra
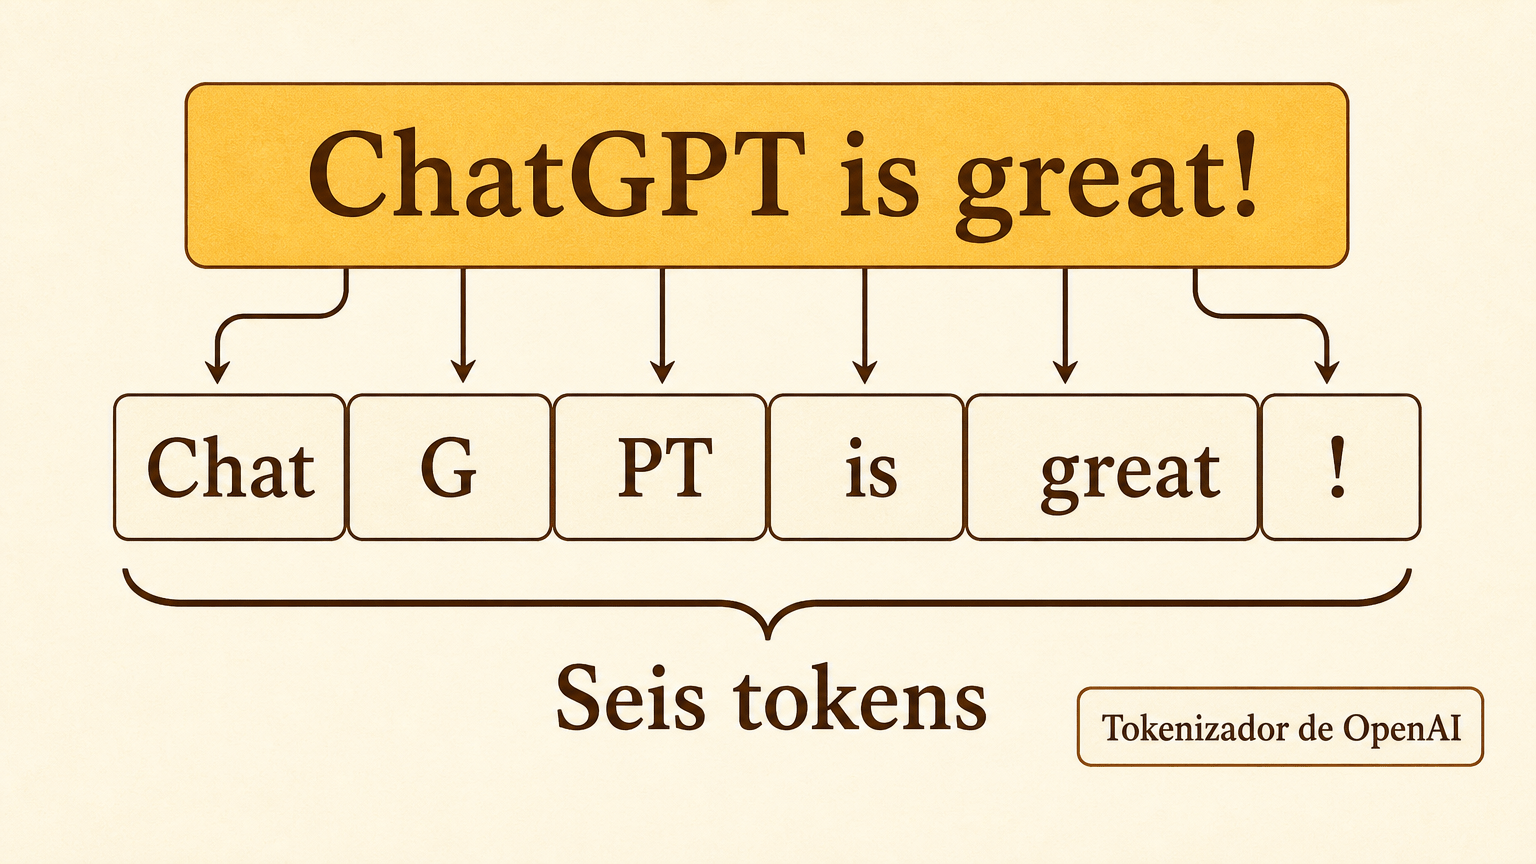
Un token puede ser un carácter, parte de una palabra, una palabra entera o un signo de puntuación, y los espacios también cuentan, según la ayuda de OpenAI. OpenAI publica, por ejemplo, que «ChatGPT is great!» se divide en seis tokens: «Chat», «G», «PT», « is», « great» y «!» (documentación de OpenAI).
Hay reglas orientativas, pero son para el inglés: un token son unos cuatro caracteres o tres cuartos de palabra, y 100 tokens rondan las 75 palabras. En castellano la proporción cambia, así que tómalas como brújula, no como báscula.
Del texto a los tokens: tokenizador y BPE
El tokenizador es quien trocea: divide el texto y da a cada pieza un número, que es lo que el modelo maneja de verdad. Ese proceso es la tokenización.
Muchos tokenizadores usan BPE (byte pair encoding). La idea es intuitiva: se parte de piezas mínimas y se fusionan, una y otra vez, los pares que más aparecen juntos. Lo muy frecuente acaba en una sola pieza y lo raro se queda en fragmentos.
Ojo: cada modelo puede usar un tokenizador distinto y contar el mismo texto de forma diferente. Además, algunos contabilizan de otra manera las imágenes, el audio, los documentos y los resultados de herramientas.
Tokens de entrada y de salida
Los tokens de entrada son lo que envías: tu pregunta, las instrucciones y lo que adjuntes. Los tokens de salida son los que genera el modelo al responder. Se cuentan y se cobran por separado: en el ejemplo de OpenAI, 10 de entrada más 20 de salida son 30 facturados.
Existen además los de entrada en caché, que algunos proveedores tarifican aparte, y los de razonamiento, que el modelo gasta «pensando»: no se ven, pero se facturan como salida.
Cómo se construye una respuesta
Un modelo de lenguaje predice el token más adecuado a partir de todo lo anterior. Lo añade, vuelve a predecir y, pieza a pieza, aparece la respuesta. Es como el autocompletar del móvil, pero tras haber leído muchísimo y sin copiar lo leído. El mecanismo completo lo cuenta cómo funciona la IA generativa.
La ventana de contexto
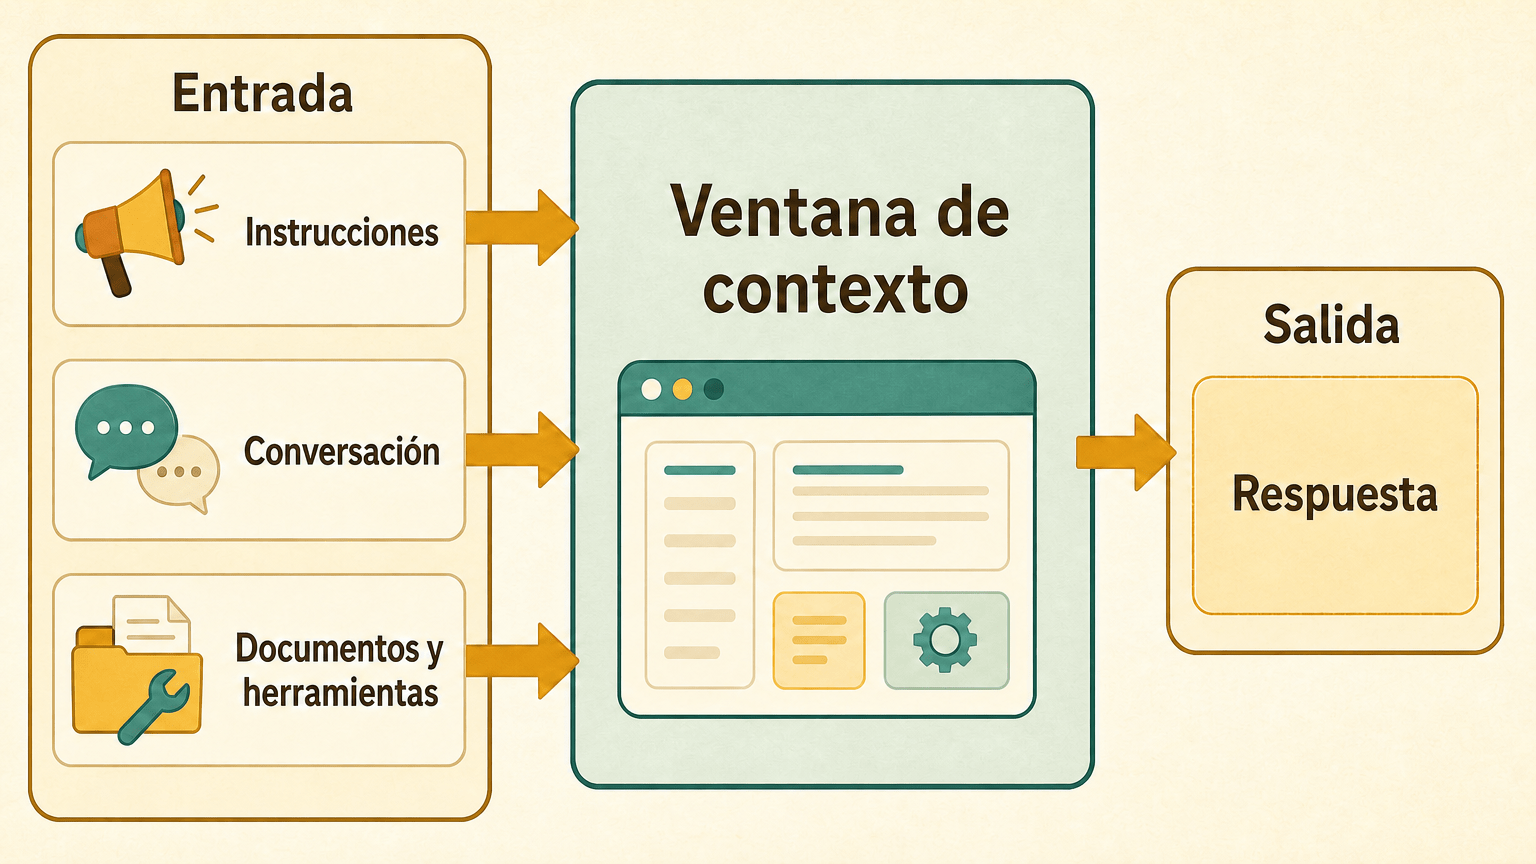
La ventana de contexto es todo el texto que el modelo puede consultar al generar una respuesta, incluida la propia respuesta. Es su memoria de trabajo, no lo aprendido en el entrenamiento, según la documentación de Anthropic. Gracias a ella mantiene el hilo.
Cada modelo tiene un máximo: GPT-5.4 Mini admite 400.000 tokens de contexto y hasta 128.000 de salida (consulta del 21 de octubre de 2026), y algunos modelos de Claude llegan a un millón. Llenarla tiene un precio: el total afecta al coste, a la duración y a si la llamada cabe.
Y más grande no significa más precisa: Anthropic advierte de que, al crecer el número de tokens, la precisión y la capacidad de recuperar información pueden degradarse.
Qué consume la ventana
Todo cuenta: las instrucciones del sistema, cada mensaje de la conversación, los documentos y las imágenes adjuntos, y los resultados y las definiciones de herramientas.
Además, se acumula: en cada turno se conserva todo lo anterior, la entrada es el historial más el mensaje nuevo, y la respuesta vuelve a entrar en el turno siguiente. Es como una maleta de mano a la que cada turno añade algo y nadie saca nada.
Tokens, parámetros y ventana: no son lo mismo
| Concepto | Qué es | Se mide en | Cambia… |
|---|---|---|---|
| Token | Pieza mínima de texto que procesa el modelo | Unidades (tokens) | Con el texto y con el tokenizador |
| Parámetros del modelo | Los «pesos» aprendidos durante el entrenamiento | Millones o miles de millones | Solo al cambiar de modelo, no al conversar |
| Ventana de contexto | El espacio de trabajo disponible en una conversación | Tokens (entrada + salida) | Por modelo, y se consume en cada turno |
Se confunden porque aparecen juntos, con cifras enormes, en las fichas de los modelos. Pero son independientes: más parámetros no implican más ventana, y la ventana no cuenta palabras.
Cómo se calcula el precio
Los proveedores cobran por millón de tokens, con una tarifa para la entrada y otra, más alta, para la salida. Con GPT-5.4 Mini, OpenAI indicaba el 21 de octubre de 2026 0,75 $ por millón de entrada y 4,50 $ por millón de salida. Una consulta de 1.500 tokens de entrada y 500 de salida sale así:
- Entrada: 1.500 / 1.000.000 × 0,75 $ = 0,001125 $.
- Salida: 500 / 1.000.000 × 4,50 $ = 0,002250 $.
- Total: 0,003375 $, unas tres décimas de centavo de dólar.
Diez mil consultas iguales rondarían los 33,75 $. Calderilla por consulta, factura por volumen. En el catálogo público de OpenRouter (21 de octubre de 2026, 20:47 UTC), el precio de salida por millón va desde unos 0,03 $ hasta 600 $.
Barato por token no es barato en total
En ese mismo catálogo, GPT-5.4 Nano cuesta 0,20 $ de entrada y 1,25 $ de salida por millón, y GPT-5.4, 2,50 $ y 15,00 $. La ruta de compra también influye: Gemini 3.8 Flash costaba 0,825 $ y 4,125 $ en OpenRouter ese día, y 0,75 $ y 3,75 $ en la página de Google (actualizada el 19 de octubre de 2026). Además, una misma herramienta puede cambiar de modelo: lo explica por qué una misma IA puede utilizar distintos cerebros.
Un supuesto ilustrativo, no una medición. Caso A: GPT-5.4 Mini, con 4.000 tokens de entrada y 800 de salida, cuesta 0,0066 $. Caso B: GPT-5.4 Nano, más barato por token, necesita 20.000 de entrada y 6.000 de salida y cuesta 0,0115 $: un 74,2 % más. Influyen la longitud, los reintentos, el razonamiento facturado como salida y el idioma.
Cuando la conversación se hace larguísima
Si el historial no cabe, hay que truncar, omitir o reducir texto; y al quitar un mensaje, el modelo pierde todo conocimiento de él, según OpenAI. Algunas aplicaciones lo resuelven por ti: Anthropic describe, por ejemplo, compactar el contexto en el servidor. Qué hace cada una (cortar, resumir o avisar) varía, así que no lo des por hecho.
Consejos para no malgastar tokens
- Abre una conversación nueva cuando cambies de tema.
- Adjunta solo la parte del documento que importa.
- Da instrucciones claras desde el principio: cómo dar instrucciones a una IA y comprobar sus respuestas ahorra más reintentos que cualquier recorte.
- Si algo es crucial en una charla larga, repítelo o resúmelo, porque el contexto grande no garantiza precisión.
- Compara tarifas con su fecha: cambian.
No hace falta contar palabras con lupa: ahorrar tres es calderilla. Lo que pesa son los documentos enormes, los historiales interminables y los modelos sobredimensionados.
Para ampliar información
- OpenAI: Understanding and counting tokens
- OpenAI: Key concepts
- OpenAI: Advanced usage
- OpenAI: ficha del modelo GPT-5.4 Mini
- OpenAI: precios de la API
- OpenAI: cómo se desarrollan ChatGPT y sus modelos de lenguaje
- tiktoken, tokenizador BPE de OpenAI (GitHub)
- Anthropic: Context windows
- Anthropic: ventanas de contexto de 100.000 tokens (mayo de 2023)
- Google: precios de la API de Gemini
- OpenRouter: catálogo público de modelos
- OpenRouter: planes y precios
- Sebastian Raschka: BPE desde cero