Jev: qué es la nueva IA que toma decisiones en lugar de generar texto
Jev, una IA que decide en lugar de escribir
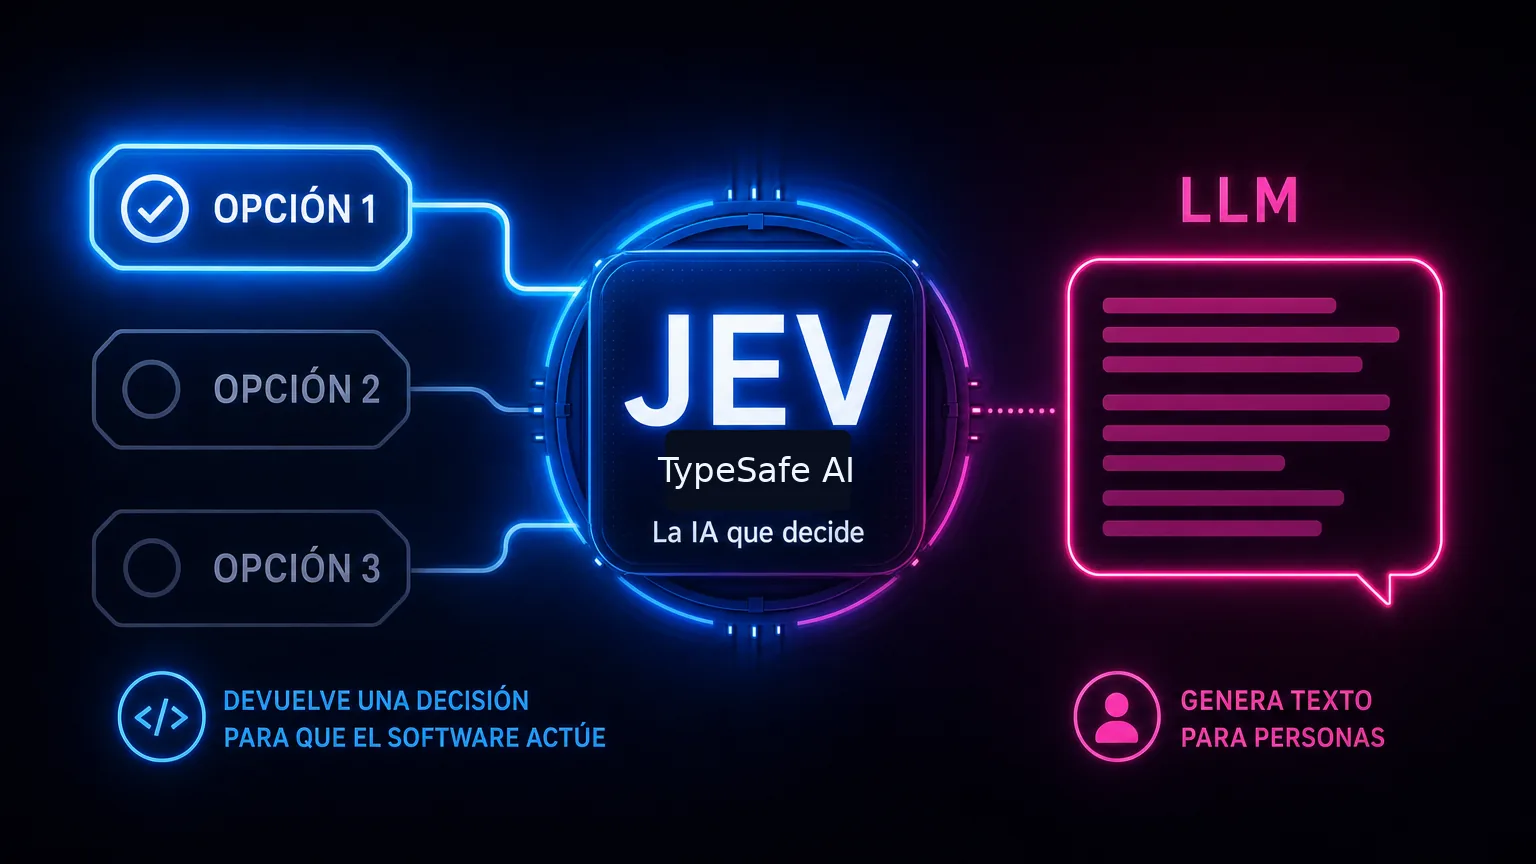
Jev es un modelo de inteligencia artificial que no redacta: decide. Lo desarrolla la empresa estadounidense TypeSafe AI y, en lugar de párrafos, devuelve valores concretos: una opción de una lista, una puntuación o un sí o un no con su probabilidad. No es un asistente con el que charlar: es una pieza que otros programas consultan para pedirle un juicio rápido. Datos actualizados al 18 de octubre de 2026.
Quién está detrás
TypeSafe AI tiene sede en San Francisco, se fundó en 2024 y pasó dos años en sigilo hasta presentarse el 15 de septiembre de 2026, según su anuncio de lanzamiento. Su consejero delegado, Diogo Almeida, fue investigador en OpenAI y trabajó en la línea que dio lugar al entrenamiento de ChatGPT. Lo acompañan Sasha Sheng, antes ingeniera en Meta, y Erik Gafni. El nombre de Jev homenajea al economista William Stanley Jevons, que describió la paradoja del carbón: más eficiencia, más consumo.
El problema: pedirle a un novelista que rellene un formulario
Los grandes modelos de lenguaje producen texto pensado para personas. Pero muchas tareas de un programa no piden conversación: solo elegir una opción, clasificar una solicitud o asignar una prioridad. Aun así, se le pide eso a un generador de texto, que responde en un formato rígido y después hay que analizar y validar lo devuelto, como explica la documentación de TypeSafe. Es pedirle a un novelista que rellene un formulario.
System One: una analogía, no un cerebro
TypeSafe llama a esta familia System One Models, en referencia a Daniel Kahneman y su libro Pensar rápido, pensar despacio. Es una analogía, no la descripción de una mente; y tampoco significa que todos los modelos de lenguaje sean «Sistema 2», porque también tienen modos rápidos.
Cómo funciona, sin jerga
El programa envía tres cosas: la información que hay que evaluar, la versión de Jev que responde y una lista de preguntas. Jev no genera texto: contesta con valores de forma predefinida, con probabilidades y, a veces, un valor de confianza. Evalúa todas las preguntas a la vez, cada una por separado contra la misma información, así que añadir preguntas apenas cambia el tiempo de respuesta. Funciona mejor con preguntas concretas y bien delimitadas.
IA que conversa frente a IA que decide
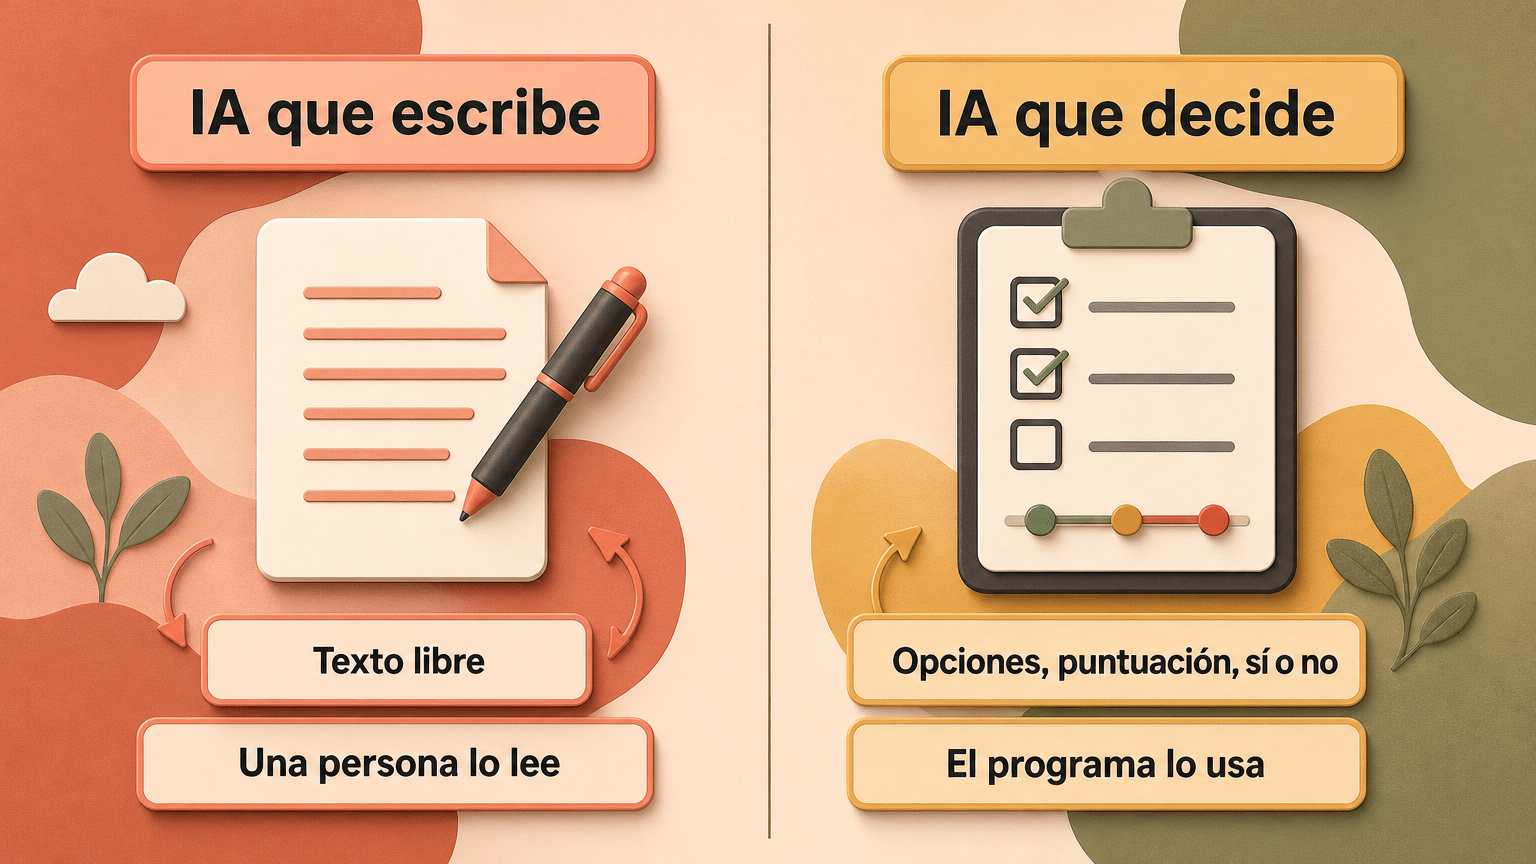
| IA conversacional | IA de decisiones (Jev) | |
|---|---|---|
| Qué devuelve | Texto libre | Valores de formato fijo |
| Quién lo lee | Una persona | Otro programa |
| Punto fuerte | Explicar y redactar con matices | Clasificar, puntuar y elegir rápido |
| Riesgo principal | Salirse del formato o inventar | Acertar en la forma y fallar en el fondo |
Tres tipos de pregunta
Choice elige una opción de una lista cerrada y devuelve la elegida con su distribución de probabilidades y una confianza. Score valora sobre una escala de 2 a 10 niveles y puede dar un valor intermedio. Noul responde sí o no con un número entre 0 y 1. Matiz importante: Choice devuelve la opción más probable, no una certeza, y una confianza alta solo indica que el modelo no está dividido, no que acierte.
Un ejemplo: mensajes de clientes
Imagina una tienda que recibe: «Mis zapatillas llegaron con la talla equivocada, ¿puedo cambiarlas por una 10?». Puede plantear a la vez varias preguntas de tipo choice: qué departamento debe atenderlo, por qué quiere devolver el producto y qué solución pide.
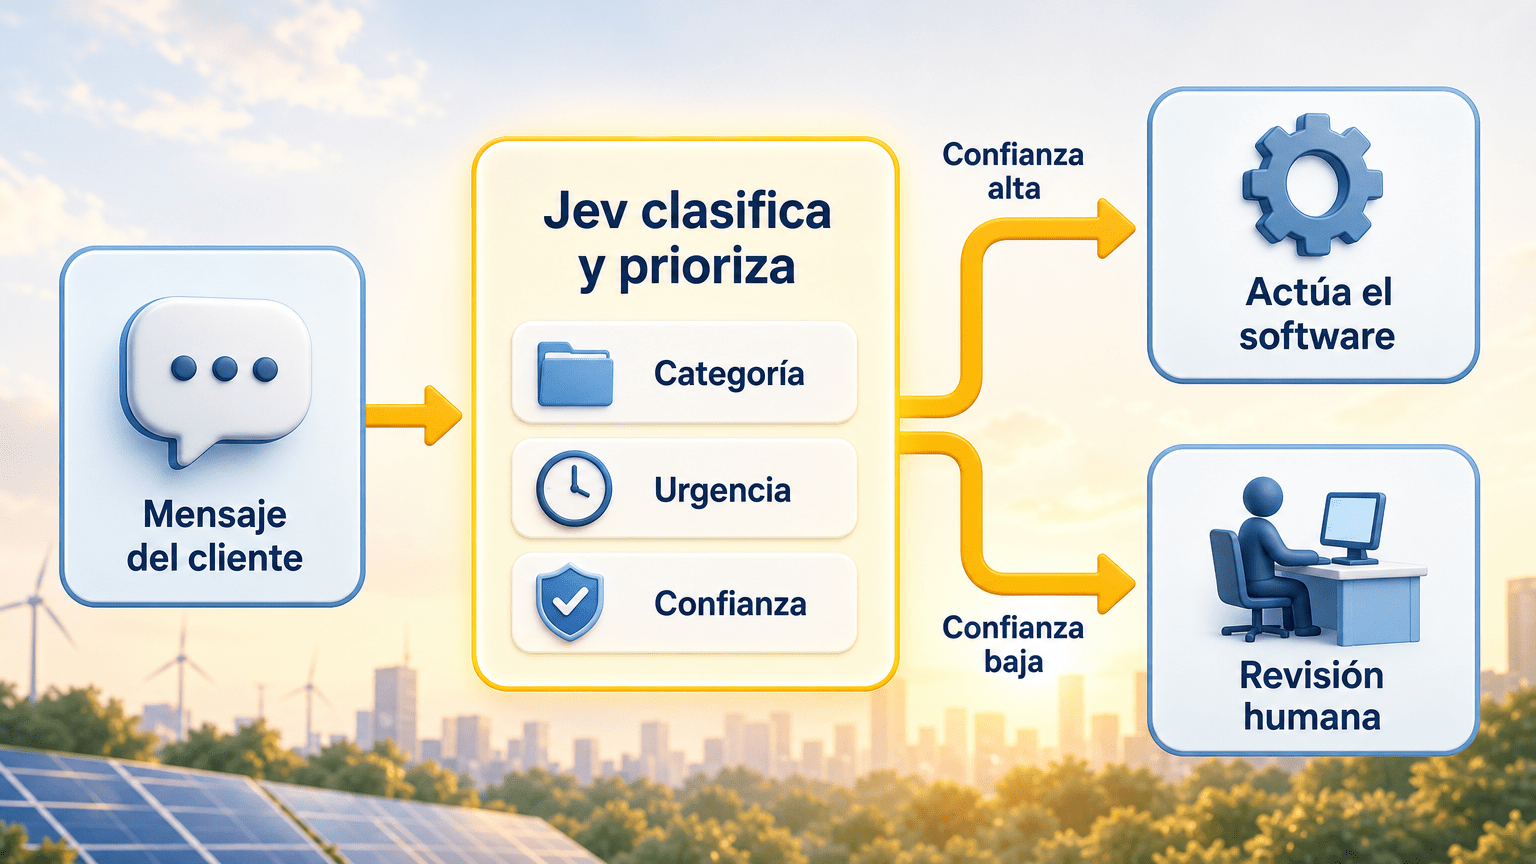
Con esas respuestas decide el software de la tienda, no Jev: si la confianza supera el umbral fijado, actúa; si no, el mensaje pasa a una persona. Las reglas, los umbrales y los permisos los define quien integra el modelo, la misma lógica de dar permisos a un agente sin perder el control.
Por qué puede ser rápido y barato, según la empresa
Generar texto palabra a palabra es secuencial y costoso; devolver decisiones acotadas en una sola pasada paralela es mucho más corto. TypeSafe publica respuestas de 70 a 500 milisegundos frente a los 3 a 329 segundos de los modelos de frontera con los que se compara, y afirma que en sus evaluaciones es hasta 193,6 veces más rápido y 444,6 veces más barato. Son cifras suyas, no mediciones independientes. Su método de entrenamiento, RLCD, busca que un 0,9 signifique un 90 % de aciertos: una aspiración de calibración, no un porcentaje infalible.
Qué cuestan estas decisiones
El precio publicado es de 0,042 dólares por millón de tokens de entrada, y los de salida son gratis. Es el precio del modelo, no el del sistema completo: hay que sumar el trabajo de definir preguntas y umbrales, el código de integración, la revisión humana de los casos dudosos y el mantenimiento cuando cambia la versión, partidas que repasa cuánto cuesta incorporar IA a un negocio. TypeSafe espera que el precio baje y reconoce que no puede demostrar que el actual no esté subvencionado.
Un arranque fuerte, acotado a Vercel
Vercel publicó que Jev fue el modelo de adopción más rápida de su pasarela: casi el 13 % de los equipos de pago en 24 horas. Su índice de producción de octubre eleva la cifra al 35 % en dos semanas, pero con solo el 0,27 % del gasto. Ese 35 % se refiere únicamente a equipos de pago de Vercel AI Gateway, no al mercado entero: mucha adopción y poco gasto encaja con un modelo muy barato usado para decisiones puntuales.
La financiación del 9 de octubre
El 9 de octubre TypeSafe anunció una Serie A de 870 millones de dólares con una valoración de 7.500 millones, según TechCrunch. La lidera Andreessen Horowitz, con Sequoia Capital y DCVC. La valoración había pasado de unos 200 millones a 7.500 en 24 días. No conviene mezclar conceptos: la financiación es el dinero que entra; la valoración, el precio teórico que los inversores asignan a la empresa; y una adquisición sería comprarla o que ella compre otra, algo que aquí no ocurre. La empresa asegura además que un tercio del Fortune 500 ya usa Jev: una declaración suya, sin nombres de clientes.
La actualización del 14 de octubre
Jev 1.14.0 llegó el 14 de octubre con mejoras generales y su mayor avance en soporte multilingüe, según el blog de TypeSafe. Añade tres funciones experimentales bajo el aviso «zona de peligro»: entrada de imágenes, un tipo de respuesta que devuelve un rectángulo delimitador y contexto ampliado. La empresa dice que no las avala para producción. Lo recomendado sigue siendo el modelo estable: 64.000 tokens de contexto por petición, 32.000 por pregunta y entrada de texto.
Limitaciones y riesgos
TypeSafe presume de «0 % de errores de tipo», pero aclara que no es una tasa medida: es la garantía de que la respuesta encaja con el formato. Una respuesta puede ser perfecta en la forma y equivocada en el fondo; que el anuncio diga que Jev «no puede alucinar» se refiere a la estructura, no a la verdad de lo decidido. Una confianza alta tampoco equivale a acierto, y un formato cerrado no vuelve fiable el contenido que se le da. Cuando algo falla, quién responde cuando una IA se equivoca sigue necesitando una respuesta humana.
Qué significa para los agentes
La propuesta no es sustituir a los modelos conversacionales, sino repartir el trabajo: uno conversa y redacta; otro decide rápido y barato dentro del mismo flujo. La documentación sugiere usos como elegir la siguiente herramienta o decidir si un proceso continúa. Para situarlo sirven qué son los agentes de IA y qué tareas puede hacer un agente. Un agente toma muchas decisiones pequeñas y no puede esperar segundos ni pagar una conversación completa por cada una: ahí encaja una IA que decida rápido. Los modelos de lenguaje siguen siendo imprescindibles para el lenguaje; lo que cambia es que ya no tienen por qué hacerlo todo.
Para ampliar información
- Web oficial de TypeSafe AI
- Documentación: tipo de pregunta choice
- Documentación: tipo de pregunta score
- Documentación: tipo de pregunta noul
- Documentación: versiones, contexto y precios
- Anuncio de la financiación del 9 de octubre
- Caso de uso publicado por el fabricante