¿Qué es un LLM y cómo funciona la inteligencia artificial que genera texto?
Cada vez que le pides a un asistente de IA que te resuma un correo o te traduzca un párrafo, hay un motor trabajando por debajo. Tiene siglas: LLM. Aquí vemos qué es un LLM, qué pasa dentro cuando le escribes un mensaje y por qué un sistema que va adivinando la pieza siguiente puede hacer cosas tan distintas. Sin fórmulas y sin saber informática.
Qué significan las siglas LLM
LLM viene del inglés Large Language Model: modelo de lenguaje grande. Empecemos por la parte más sencilla, qué es un modelo de lenguaje. Según la definición técnica de Google en su Introduction to Large Language Models, es un modelo que estima la probabilidad de un token, o de una secuencia de tokens, dentro de una secuencia más larga. Un token es una pieza de texto: puede ser una palabra entera, un trozo de palabra o un solo carácter.
Piensa en «Esta tarde voy a tomar un…»: casi cualquiera esperaría «café» antes que «submarino». Un modelo de lenguaje hace algo parecido, pero con números.
¿Y lo de «grande»? Alude al tamaño del modelo, a los datos con que se entrena y al número de parámetros, sus números internos. Eso sí, no mezclemos: no todos los modelos de IA son LLM (el que reconoce caras en tus fotos no lo es), ni todo el aprendizaje automático consiste en generar texto.
LLM, chatbot y aplicación no son lo mismo
Decimos «le he preguntado a la IA» como si fuera una sola cosa. Hay tres capas:
- El modelo (el LLM) es el motor. Es el que calcula qué texto encaja a continuación.
- El chatbot es la interfaz con la que conversas: la ventana donde escribes y lees.
- La aplicación o servicio es el producto completo. Envuelve el modelo, decide cuál usar, guarda tu historial, añade instrucciones propias que tú no ves y puede conectar herramientas.
Por eso una misma aplicación puede cambiar de modelo sin que te enteres, igual que un coche cambia de motor y sigue llamándose igual: el nombre comercial del servicio no es el del modelo. Si buscas LLM ejemplos, los más conocidos están detrás de asistentes como ChatGPT o Claude, pero asistente y modelo son cosas distintas.
Por qué aprende patrones estadísticos
Un LLM no guarda frases como un archivador ni consulta una base de datos de hechos: aprende patrones estadísticos del texto con el que se entrena y genera lenguaje que sigue esos patrones. IBM lo describe en What are large language models (LLMs)? como enormes máquinas estadísticas de predicción.
Se compara a menudo con el autocompletar del móvil, pero la comparación se queda corta: el modelo no repite frases vistas, sino que construye secuencias nuevas.
De aquí sale la idea que recorre el artículo: el modelo no «sabe» qué es verdadero, sino qué encaja en el patrón. Casi siempre ambas cosas coinciden, y por eso resulta tan útil.
Para situarlo en un mapa más amplio, repasa Qué es la inteligencia artificial: explicación sencilla con ejemplos cotidianos y IA, machine learning y deep learning: diferencias con ejemplos.
El preentrenamiento: leer mucho para ajustar los parámetros
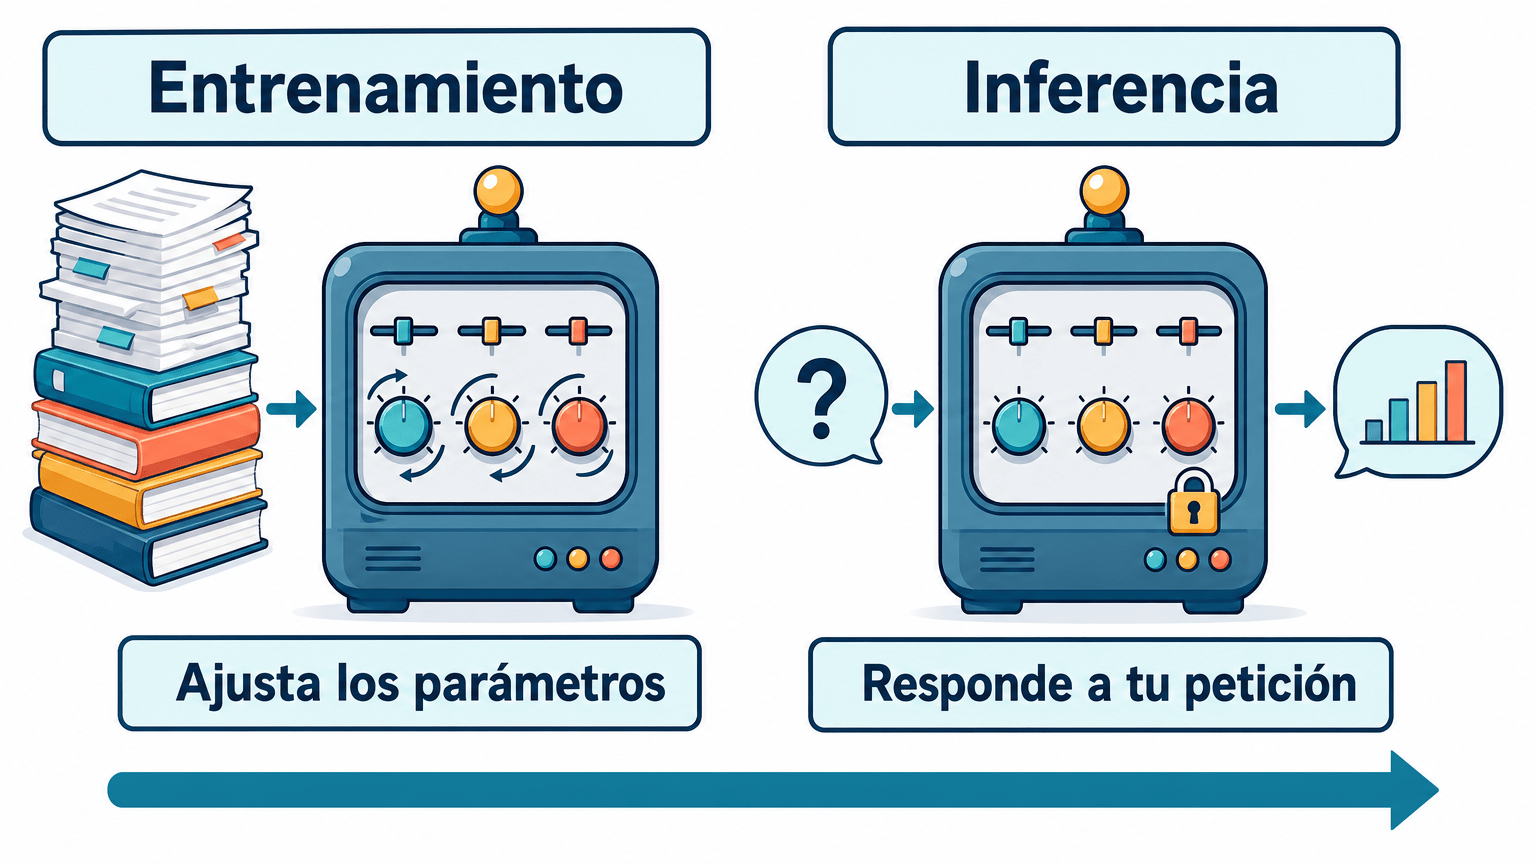
¿Cómo aprende esos patrones? Con el preentrenamiento: el modelo «lee» cantidades enormes de texto y va ajustando sus parámetros. Cada ajuste es minúsculo, pero repetido muchísimas veces produce un modelo capaz de manejar el lenguaje.
La forma habitual de hacerlo es el aprendizaje autosupervisado: la respuesta sale del propio texto. Se oculta la palabra siguiente, el modelo intenta adivinarla y se compara con la que realmente aparecía, así que nadie tiene que etiquetar millones de ejemplos a mano. Las diferencias con otros tipos de aprendizaje están en Aprendizaje supervisado y no supervisado: cómo aprende una inteligencia artificial.
El resultado es un modelo de base (preentrenado): sabe mucho de gramática, palabras y expresiones, pero para tareas concretas suele necesitar un ajuste posterior. Y no es barato: reunir los datos y entrenar durante meses consume mucho tiempo, recursos y energía.
Cómo genera texto: el siguiente token
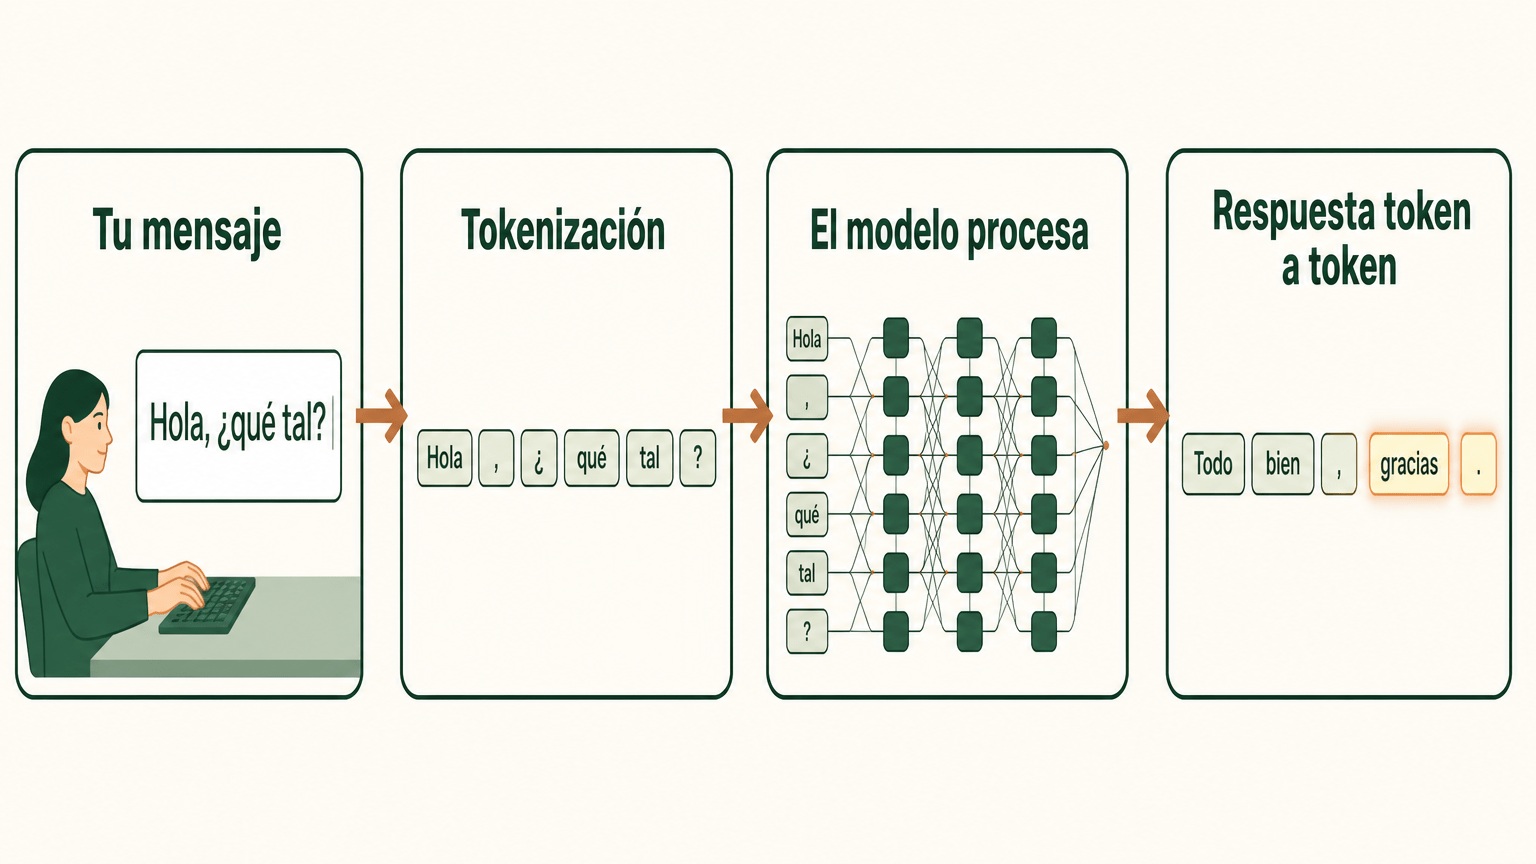
Este es el mecanismo central de los LLM generativos. Cuando envías un mensaje, el sistema lo trocea en tokens, calcula probabilidades para los posibles siguientes y elige uno. Luego lo añade al texto y repite el proceso con todo lo anterior hasta completar la respuesta. Por eso se dice que el modelo es autorregresivo: cada paso se apoya en lo que él mismo acaba de generar.
Veamos una simplificación conceptual: las probabilidades de este ejemplo son inventadas y solo ilustran la idea. Un modelo real maneja muchísimos candidatos a la vez.
Imagina que queremos construir «El cielo está despejado»:
- Con «El», valora las continuaciones posibles: «cielo» (30 %), «niño» (10 %) y muchas más. Elige «cielo».
- Con «El cielo», valora «está» (45 %), «azul» (15 %) y otras. Elige «está».
- Con «El cielo está», valora «despejado» (40 %), «nublado» (25 %) y otras. Elige «despejado».
- Con «El cielo está despejado», el punto final es la opción más natural y cierra la frase.
Así, pieza a pieza, se levanta un texto entero: no hay un plan escrito de antemano, cada token se decide con lo que ya hay delante. Qué es una de esas piezas y por qué influye en el coste, en ¿Qué son los tokens en inteligencia artificial y por qué cuestan dinero?.
Parámetros y tokens no son lo mismo
Es fácil confundirlos, porque ambos se cuentan por muchísimos:
- Los parámetros son los números internos del modelo, ajustados durante el entrenamiento: en cierto modo, lo que ha «aprendido».
- Los tokens son las piezas en que se trocea el texto al entrar o salir del modelo.
Como imagen: los parámetros son la receta aprendida, y los tokens, los ingredientes y los platos. Esta tabla resume los conceptos clave:
| Concepto | Qué es | Ejemplo |
|---|---|---|
| LLM | Un modelo de lenguaje de gran tamaño, entrenado con mucho texto. | El motor que hay detrás de un asistente de escritura. |
| Modelo | El sistema matemático ya entrenado, con sus parámetros ajustados. | El «cerebro» que calcula la continuación del texto. |
| Chatbot | La interfaz con la que conversas con un modelo. | La ventana donde escribes tus preguntas. |
| Token | Una pieza de texto: palabra, parte de palabra o carácter. | «des» y «pejado» pueden ser dos tokens. |
| Parámetro | Un número interno del modelo, ajustado al entrenar. | Cada uno es un pequeño «botón» de un panel gigantesco. |
| Contexto (ventana de contexto) | El espacio de tokens con el que trabaja el modelo en una petición. | Tus instrucciones, la conversación y la respuesta, todo junto. |
Redes neuronales y la arquitectura Transformer
Por dentro, un LLM es una red neuronal enorme: muchísimas unidades sencillas conectadas entre sí, inspirada de forma muy libre en el cerebro. La base está en Neuronas reales y artificiales: cómo funcionan y cómo aprenden.
La arquitectura que hizo posible los LLM actuales es el Transformer, presentado en 2017 en el artículo «Attention Is All You Need». Google lo resume así: un codificador convierte el texto de entrada en una representación intermedia y un decodificador la convierte en texto útil. La clave es la autoatención, que permite pesar la importancia de unas palabras respecto a otras: en «Lucía le dio el libro a Marta porque ella lo había pedido», ayuda a decidir a quién se refiere «ella».
Es solo un adelanto, porque el próximo artículo de la serie trata el Transformer en detalle. Y una aclaración: el Transformer no es exclusivo de la generación de texto; se usa en otras tareas, y el artículo original ya lo aplicó al análisis sintáctico de oraciones.
La ventana de contexto
La ventana de contexto es el espacio de tokens con el que trabaja el modelo en una petición. Según la documentación de Anthropic sobre Context windows, incluye todo lo que se envía (instrucciones, conversación, documentos, resultados de herramientas) y también lo que el modelo genera. Anthropic cita ventanas de 200.000 o 1.000.000 de tokens, pero aclara que varían según el modelo: no hay un número universal.
Una analogía, no una descripción técnica: es como una mesa de trabajo, y el modelo solo puede usar lo que hay encima. Cuando la conversación se alarga, la aplicación tiene que resumirla o recortarla, y por eso a veces el asistente «se olvida» de algo que dijiste al principio.
Entrenamiento, ajuste posterior e inferencia
Son tres momentos distintos en la vida de un modelo, y conviene no mezclarlos:
- Entrenamiento: el modelo aprende de los datos y ajusta sus parámetros.
- Ajuste posterior (fine-tuning): adaptar un modelo ya entrenado a una tarea concreta con pocos ejemplos; Google, en LLMs: Fine-tuning, distillation, and prompt engineering, habla de unos cientos o miles.
- Inferencia: usar el modelo ya entrenado para responder, en línea o por lotes.
Como analogía, el entrenamiento es estudiar y la inferencia, hacer el examen, con la ventaja de que el examen se repite millones de veces sin volver a estudiar. Existe además la destilación: crear una versión más pequeña de un modelo grande.
Para qué sirve un LLM: traducir, resumir, redactar, programar
¿Cómo puede un mismo modelo traducir, resumir y programar sin que nadie le enseñe cada tarea por separado? Porque todas se reducen, en el fondo, a generar la continuación adecuada a partir de un texto de entrada: si la entrada es «traduce esto al francés:» seguido de una frase, la continuación adecuada es la traducción. De ahí los usos cotidianos: traducir un mensaje, resumir un documento largo, redactar un correo, proponer código o responder preguntas.
Eso sí, los sistemas actuales son más que un predictor de texto a secas: incorporan ajuste posterior, razonamiento por pasos, herramientas y capacidades multimodales (texto, imagen, audio). Predecir el siguiente token es el mecanismo central, pero no todo es «predecir el siguiente token» sin más.
Por qué parece que razona (y qué límites tiene esa idea)
A veces un LLM resuelve un problema explicando cada paso y cuesta no pensar «esto lo está razonando»: produce texto coherente y ha aprendido los patrones del razonamiento escrito.
Conviene ser prudentes, porque hay un debate abierto. No es honesto afirmar que piensa y comprende como una persona, ni tampoco que es solo un truco sin capacidad alguna. Ayuda separar tres planos:
- Funcionamiento técnico: predicción de tokens a partir de patrones aprendidos.
- Capacidades observables: traduce, resume, resuelve problemas bien planteados.
- Debates abiertos: qué significan realmente esas capacidades.
Los dos primeros se pueden comprobar; el tercero sigue sin cerrarse. El panorama general de estos sistemas está en Cómo funciona la IA generativa: del entrenamiento a crear texto, imágenes y audio.
Alucinaciones: por qué ocurren y cómo verificar
Una alucinación es una respuesta que suena creíble pero es falsa: datos inventados, citas que no existen, direcciones web que no llevan a ninguna parte. IBM lo explica en What are AI hallucinations?: el sistema no sabe qué es verdadero o falso, sino qué encaja en el patrón. Cuando los datos escasean o la pregunta es ambigua, rellena el hueco con algo plausible, y con el mismo aplomo que si supiera de qué habla. Se pueden reducir, pero no eliminar del todo.
Algunas pautas prácticas:
- Contrasta lo importante con fuentes fiables.
- Pide las fuentes y compruébalas: no des por hecho que una referencia exista y diga lo que se afirma.
- Desconfía de cifras y citas concretas, terreno fértil para los inventos.
- No delegues decisiones que exijan exactitud sin revisión humana.
Un asistente con labia es como ese cuñado que siempre tiene una respuesta: conviene comprobar antes de repetirla en la comida familiar.
Herramientas, documentos y agentes
Un LLM solo, sin nada más, no consulta internet ni lee tus archivos: si no se le da información, solo cuenta con lo aprendido y con lo que hay en la conversación.
Para darle información fresca o propia existe la recuperación de documentos, conocida como RAG: según IBM, en What is RAG (Retrieval Augmented Generation)?, se busca información relevante en una base de conocimiento y se añade al prompt, de modo que la respuesta sea más precisa sin reentrenar el modelo. Reduce el riesgo de alucinación, pero no lo elimina.
Un agente da un paso más: IBM, en What are AI agents?, lo presenta como un sistema que añade al LLM memoria, planificación por pasos, uso de herramientas por API y capacidad de encadenar tareas. Cómo colaboran varios, en Cuando las inteligencias artificiales trabajan en equipo: así funcionan los sistemas multiagente.
En la nube o en tu ordenador
Los modelos pueden ejecutarse de dos maneras:
- En la nube: los usas por internet, no ocupan espacio en tu disco y suelen ser los más capaces. A cambio, envías tus datos a un servicio externo y necesitas conexión.
- En local: corren en tu propio ordenador, no dependen de la conexión y tus datos no salen de casa. El precio es que suelen ser modelos más pequeños, más lentos o con menos capacidad, y que necesitas un equipo adecuado.
Si te apetece probar la opción local, tienes LM Studio vs. Ollama: diferencias y cuál elegir para utilizar IA local y Qué ordenador necesitas para ejecutar inteligencia artificial local.
El futuro de los asistentes y los agentes
El LLM deja de ser un cuadro de texto para convertirse en el motor de asistentes personales y de agentes que actúan en tu nombre. La diferencia no la marca solo el modelo, sino las herramientas que puede usar, la memoria que conserva y los permisos que se le dan.
Y cuanta más autonomía, más importante es la revisión humana. IBM explica en What is RLHF? que el aprendizaje por refuerzo con retroalimentación humana ajusta el comportamiento del modelo con recompensas y penalizaciones: las personas seguimos en el circuito, y conviene que sigamos.
Preguntas frecuentes
¿Un LLM piensa? Es un debate abierto: técnicamente predice tokens a partir de patrones aprendidos, y sus capacidades observables son notables, pero no conviene afirmar ni que piensa como una persona ni que es solo un truco.
¿Entiende lo que lee o solo completa frases? Las dos descripciones se quedan cortas: funciona prediciendo texto que encaja, y eso le permite responder con sentido, pero si eso equivale a «comprender» como lo hacemos nosotros sigue siendo materia de debate.
¿Por qué se inventa datos? Porque no distingue lo verdadero de lo falso, solo lo que encaja en el patrón. Cuando faltan datos o la pregunta es ambigua, rellena el hueco con algo plausible, de modo que conviene verificar cifras, citas y enlaces.
¿Puede consultar internet solo? No: sin una herramienta que se lo permita, solo cuenta con lo aprendido y con la conversación. Si una aplicación busca en la web o lee tus documentos, es porque se le han conectado esas capacidades.
¿Qué diferencia hay entre un LLM y el ChatGPT que uso? El LLM es el modelo, el motor; ChatGPT es una aplicación que lo envuelve, con su chat, su historial y sus instrucciones propias (lo vimos al principio del artículo).
Para ampliar información
- Google, «Introduction to Large Language Models»
- Google, «LLMs: What’s a large language model?»
- Google, «LLMs: Fine-tuning, distillation, and prompt engineering»
- Google, Glosario de machine learning
- Vaswani et al., «Attention Is All You Need» (2017)
- IBM, «What are large language models (LLMs)?»
- IBM, «What are AI hallucinations?»
- IBM, «What is RAG (Retrieval Augmented Generation)?»
- IBM, «What are AI agents?»
- IBM, «What is RLHF?»
- Anthropic, «Context windows»
- OpenAI, «Understanding and counting tokens»