¿Hasta dónde debemos dejar actuar a un agente de IA?
Redacción LedSolEo
Pedirle a una IA que te sugiera un hotel es una cosa. Dejar que lo reserve, lo pague y avise a tu jefe es otra. Entre ambas hay una pregunta: ¿hasta dónde dejamos actuar a un agente? Sobre cómo conceder permisos ya hablamos en «Cómo dar permisos a un agente de IA sin perder el control»; este artículo se centra en cuánto actuar.
De responder a actuar
Un chatbot recibe una pregunta y devuelve un texto. Si se equivoca, lo peor suele ser que leas algo incorrecto. Un agente, además de conversar, usa herramientas: consulta un calendario, abre un documento, rellena un formulario o envía un mensaje.
OpenAI, en su guía práctica para construir agentes, lo define como un sistema que completa tareas de forma independiente en nombre de la persona. Es la diferencia entre mirar la carta y pedir la cena: lo primero no te compromete a nada, lo segundo acaba en tu mesa (y en tu cuenta).
Qué significa autonomía de verdad
Autonomía no es solo «hacer cosas solo». Un agente con autonomía de verdad recibe un objetivo, planifica cómo alcanzarlo, elige herramientas, ejecuta acciones y comprueba si el resultado es el esperado.
La guía de OpenAI añade un detalle importante: reconoce cuándo ha terminado y, si algo falla, puede detener la ejecución y devolver el control. Saber parar forma parte de la autonomía.
Y una aclaración necesaria: autonomía no significa conciencia ni voluntad propia. El agente no «quiere» nada; sigue un objetivo que le ha dado una persona, dentro de las herramientas y los límites que el sistema le ofrece.
Una escala de cuatro peldaños
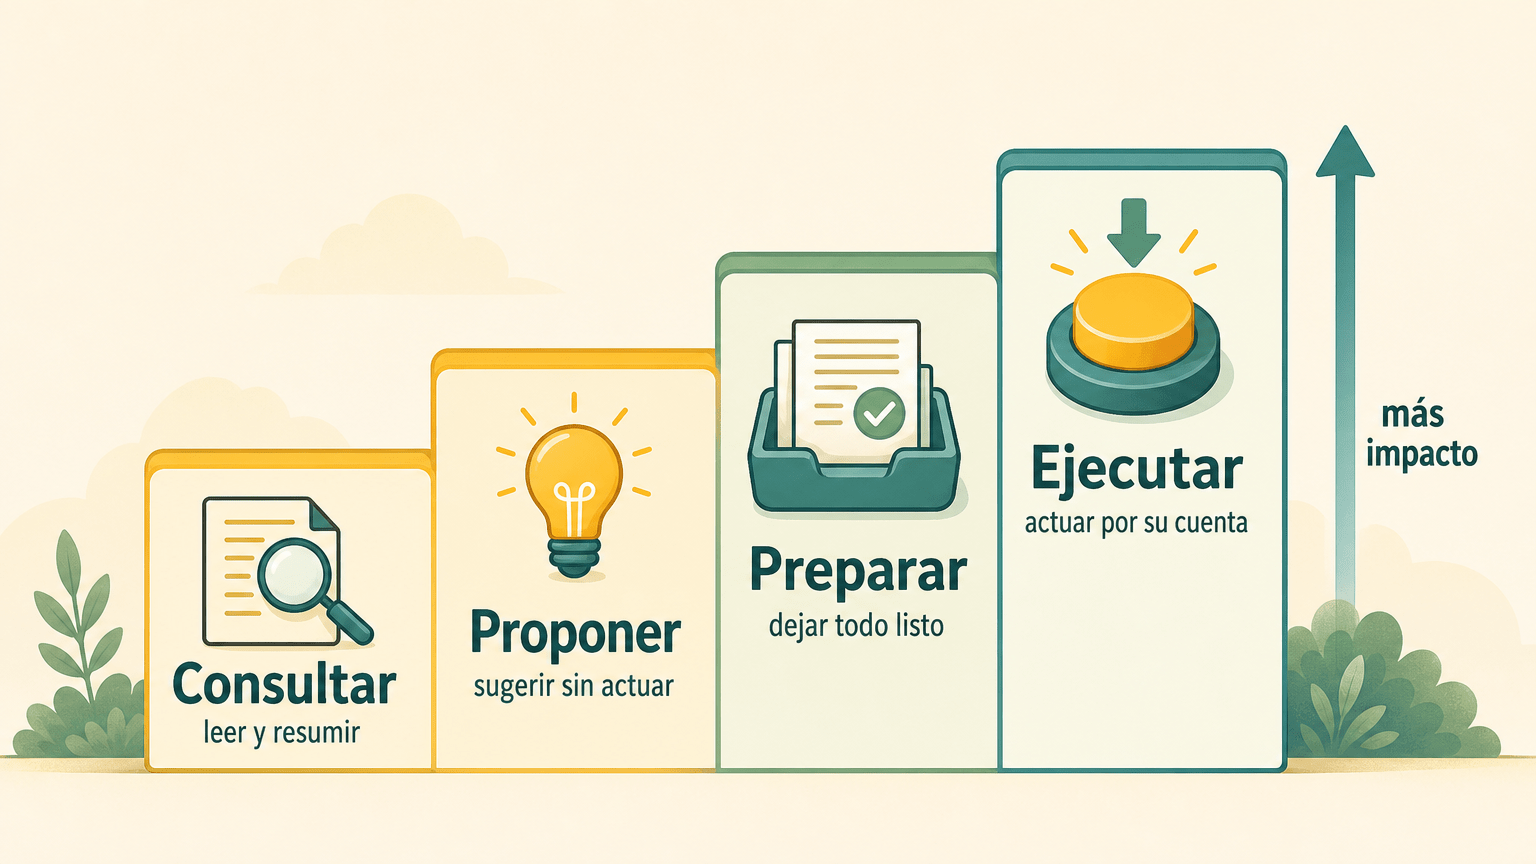
Una escala ayuda a decidir cuánta libertad dar. Es una forma de ordenar las ideas que proponemos desde la redacción, no un estándar oficial:
- Consultar: lee información y te la resume. No cambia nada.
- Proponer: sugiere qué hacer; la decisión y la acción son tuyas.
- Preparar: deja la tarea lista (un borrador, un carrito) sin completarla.
- Ejecutar: lleva a cabo la acción por su cuenta.
No hay que elegir un único peldaño para todo: un mismo agente puede ejecutar una consulta y quedarse en «preparar» cuando se trata de dinero.
Leer no es enviar
Cada peldaño supone un riesgo distinto, y por eso no son equivalentes estas parejas:
- Leer un correo o enviarlo. Leer no altera nada; enviar sale de tu bandeja y ya no vuelve.
- Consultar un documento o modificarlo. Mirar es inofensivo; editar puede estropear el original.
- Preparar una compra o realizarla. Un carrito lleno no cuesta nada; el pago, sí.
OpenAI recomienda valorar el riesgo de cada herramienta (bajo, medio o alto) según si solo lee o escribe, si la acción se puede revertir, qué permisos necesita y qué impacto económico tiene.
Permisos, mínimo privilegio y reglas claras
El principio de mínimo privilegio dice que un agente solo debe tener acceso a lo que necesita para su tarea. Es la diferencia entre dejarle las llaves de casa a alguien para que riegue las plantas y darle, ya puestos, la tarjeta del banco.
La documentación de Claude Code describe tres tipos de regla: permitir (usar la herramienta sin preguntar), preguntar (confirmar cada vez) y denegar (bloquearla). Lo importante es que las aplica la herramienta, no el modelo: si un documento de contexto dice «puedes hacerlo todo», eso influye en lo que el agente intenta, pero no cambia lo que el sistema le permite.
Además, los mecanismos de autorización varían entre plataformas y no todos los agentes ofrecen los mismos controles. Conviene comprobarlo antes de delegar.
Reversible o irreversible
Una pregunta práctica que ayuda a decidir: ¿se puede deshacer?
- Un borrador se corrige; un envío ya llegó.
- Una consulta de precios no obliga a nada; una compra sí.
- Una edición se revierte si hay copia; un borrado puede no tener vuelta atrás.
Cuanto más irreversible es la acción, más sentido tiene la confirmación. OpenAI la incluye entre los dos disparadores de intervención humana: superar umbrales de fallo (varios intentos sin entender la petición) y las acciones de alto riesgo, como pagar o cancelar pedidos.
Lo que puede salir mal
El proyecto OWASP GenAI Security Project recoge varios riesgos de referencia:
- Instrucciones maliciosas escondidas. Es la inyección indirecta: un texto oculto en una web, un PDF, un correo o el resultado de otra herramienta que el modelo lee y puede tomar como una orden.
- Agencia excesiva. Un agente con más capacidades, permisos o autonomía de los necesarios. OWASP lo relaciona con lo anterior: cuanto más puede hacer, más daño causa una instrucción maliciosa.
- Filtración de datos. El modelo muestra información sensible que no debía.
- Consumo sin límite. Bucles que repiten operaciones y disparan el gasto; como pulsar veinte veces el botón del ascensor: no llega antes, pero alguien lo paga.
- Errores de interpretación y cadenas de decisiones equivocadas. Un malentendido inicial arrastra los pasos siguientes, razonables sobre una base errónea.
Ninguna medida elimina estos riesgos: son mitigaciones, no garantías.
Aprobaciones, registro y botón de parada
Tres mecanismos se repiten en las fuentes:
- Aprobación humana. La guía de OpenAI sobre salvaguardas y revisión describe herramientas que pausan el flujo antes de una acción sensible y lo reanudan después con el estado conservado; LangGraph habla de interrumpir, revisar, aprobar, editar o rechazar, y reanudar.
- Registro de actividad. OWASP recomienda anotar cada llamada a una herramienta con su petición y su resultado.
- Poder detener. El agente debe poder pararse, y las salvaguardas pueden bloquear una petición antes de que actúe.
OWASP añade limitar el alcance al usuario que hace la petición y poner topes de gasto.
Pedir permiso para todo tampoco funciona
Supervisarlo todo suena prudente, pero cuesta: si el agente pregunta por cada paso, acabas haciendo el trabajo tú y aprobando sin leer, y la supervisión se vuelve un trámite vacío. Esta es una interpretación de la redacción, no un dato medido.
La alternativa razonable es graduar: libertad en lo reversible y de bajo riesgo, confirmación para lo sensible. Hay modos que omiten las confirmaciones, pero Claude Code advierte de que solo valen en entornos aislados, como contenedores o máquinas virtuales.
Un viaje de ejemplo
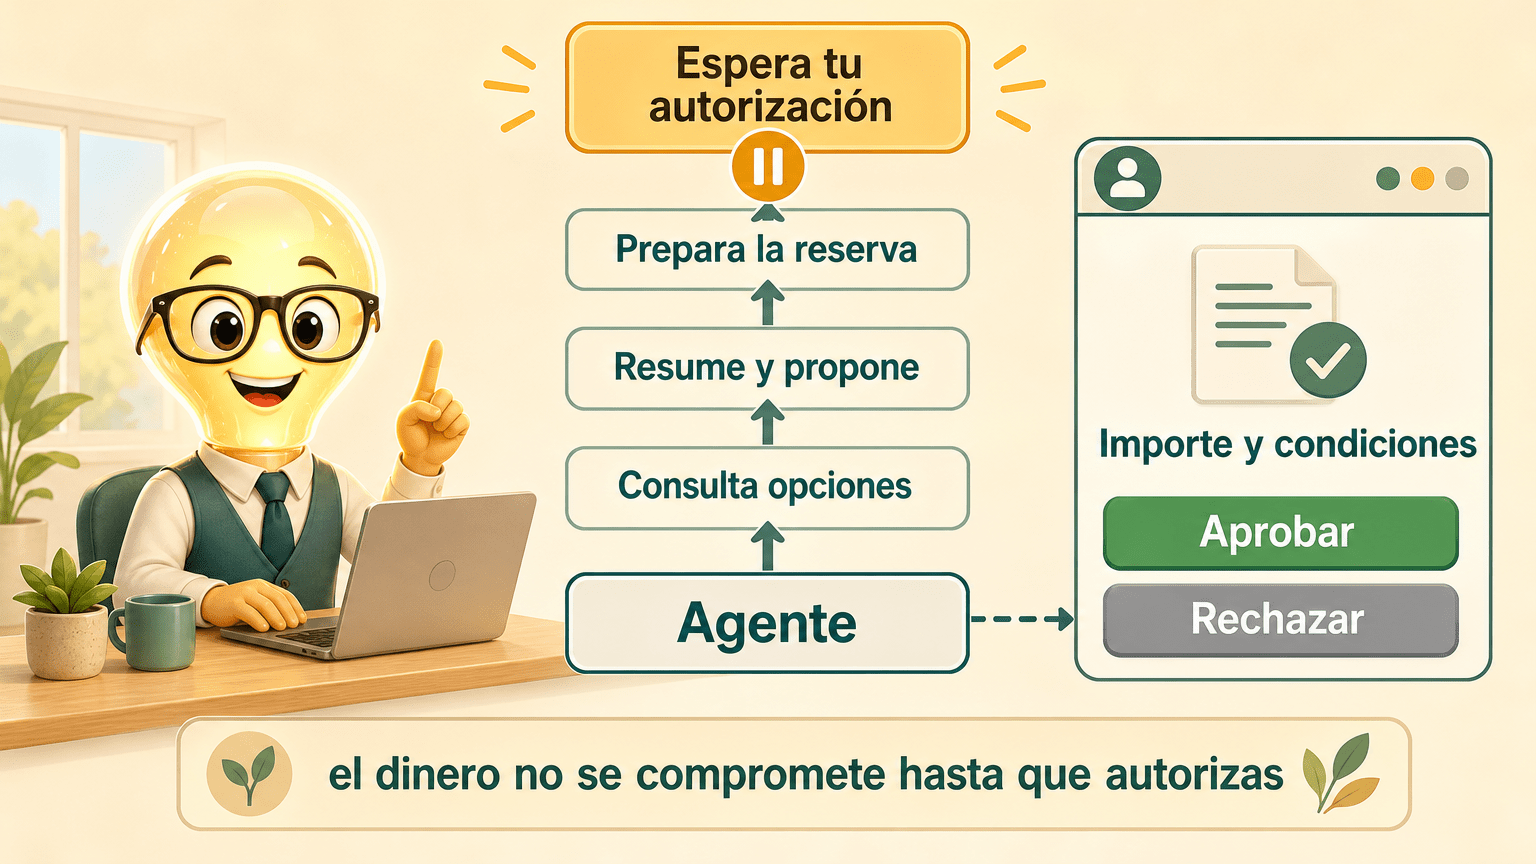
Imagina, como caso didáctico inventado, un agente al que pides organizar un fin de semana fuera. Consulta horarios y alojamientos (consultar), te resume tres combinaciones (proponer) y, cuando eliges una, rellena los datos y deja la reserva lista en el pago (preparar). Y ahí se detiene: te muestra el importe, las condiciones y la opción de cancelar, y espera tu autorización antes de comprometer dinero.
Si das el visto bueno, sigue. Si algo no cuadra, rechazas o pides cambios y el agente continúa desde donde estaba. Lo fácil de deshacer lo ha hecho solo; lo que cuesta dinero, lo decides tú.
El futuro de la autonomía
Hoy ya existen agentes que usan herramientas, piden aprobación y dejan registro, aunque no todos con las mismas garantías: eso es capacidad actual y documentada.
Lo que viene es todavía expectativa: es previsible que los asistentes personales y profesionales ganen autonomía, pero no hay motivo para dar por hecho que la seguridad crecerá igual. Cuando un fabricante recomienda aislar al agente en una máquina virtual con privilegios mínimos y sin datos sensibles, como hace Anthropic en su documentación de uso de ordenador, conviene leerlo como recomendación, no como promesa.
La pregunta útil no es «¿puede hacerlo solo?», sino «¿qué pasa si se equivoca, y quién lo ve a tiempo?».
Para ampliar información
Fuentes externas:
- OpenAI: guía práctica para construir agentes (PDF)
- OpenAI: salvaguardas y revisión humana
- Claude Code: configuración de permisos
- OWASP: Top 10 para aplicaciones con LLM
- OWASP: riesgo de agencia excesiva
- Claude: herramienta de uso de ordenador
- LangGraph: intervención humana en el flujo
Otros artículos de LedSolEo:
- Agentes de IA: qué son, cómo actúan y diferencias con un chatbot
- Tareas de un agente de IA: ejemplos útiles y límites reales
- De asistente a trabajador permanente: agentes que operan todo el día
- Cómo dar permisos a un agente de IA sin perder el control
- El alma de los agentes de IA: qué separa su inteligencia de su identidad
- La memoria de los agentes de IA: cómo recuerdan y qué pueden olvidar
- Sistemas multiagente: cuando las inteligencias artificiales trabajan en equipo
- Cómo personalizar una IA con instrucciones, preferencias y documentos
- Por qué una misma IA puede utilizar distintos cerebros