Cómo personalizar una IA con tus instrucciones, preferencias y documentos
Decirle a una IA «hazlo a mi manera» puede significar cosas muy distintas: una instrucción, una memoria guardada, una carpeta de documentos consultados o un ajuste del propio modelo. Te explicamos cada nivel, qué cambia de verdad y cómo comprobar que la IA no se está inventando lo que dice.
Personalizar una IA no es una sola cosa
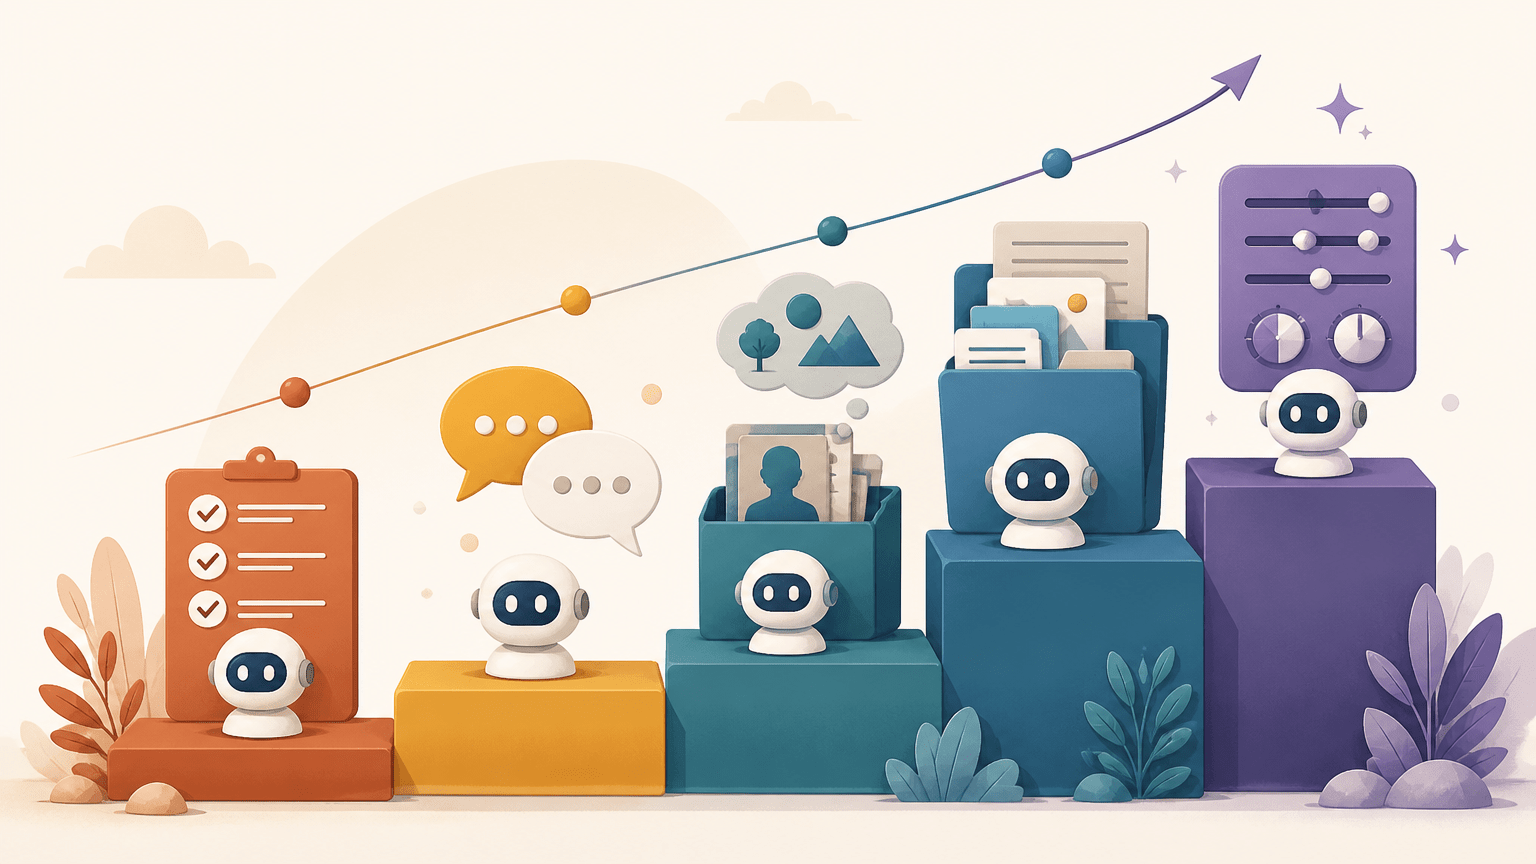
Cuando alguien dice que «ha enseñado» algo a su asistente, puede haber pasado de todo: desde escribir una frase al principio del chat hasta entrenar un modelo con ejemplos. Son mecanismos distintos, con efectos, costes y riesgos distintos.
Para ordenarlo, imagina una escalera de cinco peldaños: instrucciones, conversación, memoria, documentos y ajuste del modelo. Cuanto más subes, más potente es el cambio, pero también más trabajo y más cosas que revisar. Y no, no hace falta subirla entera: muchas veces basta con el primer escalón.
Nivel 1: instrucciones
Son reglas o preferencias que la aplicación incluye en el contexto: «respóndeme con frases cortas», «explícame como a un principiante», «si dudas, dilo». Se pueden cambiar cuando quieras sin modificar el modelo por dentro. Es como pegar una nota en la nevera: la lee quien abre la puerta, pero la nevera no cambia.
Una instrucción clara y concreta suele funcionar mejor que una vaga. Tenemos una guía para eso: cómo dar instrucciones a una IA y comprobar sus respuestas.
Nivel 2: el contexto de la conversación
Es la información que la IA tiene a mano mientras charláis: tus mensajes, sus respuestas y lo que hayas pegado. Tiene un límite de tamaño (la «ventana de contexto») y, según la aplicación, puede desaparecer al abrir otra sesión. Si ayer le contaste tu proyecto y hoy empiezas un chat nuevo, no des por hecho que lo recuerda.
Si quieres entender mejor por qué los modelos generativos trabajan así, lo contamos en cómo funciona la IA generativa.
Nivel 3: memoria persistente
Aquí la aplicación guarda datos fuera de la conversación actual para usarlos más adelante. La clave es la palabra «aplicación»: que exista memoria, qué guarda, si puedes verla, editarla o borrarla depende de cada producto, no de la IA en abstracto.
Como ejemplo de una app concreta (no como regla general), la FAQ de memoria de OpenAI explica que la memoria se gestiona con controles de la propia aplicación, que puede ser algo separado de los chats y que borrar una conversación no siempre elimina un recuerdo guardado aparte. Moraleja: mira los ajustes de la herramienta que uses, no los de la que usa tu vecino.
Nivel 4: consultar tus documentos (RAG, sin tecnicismos)
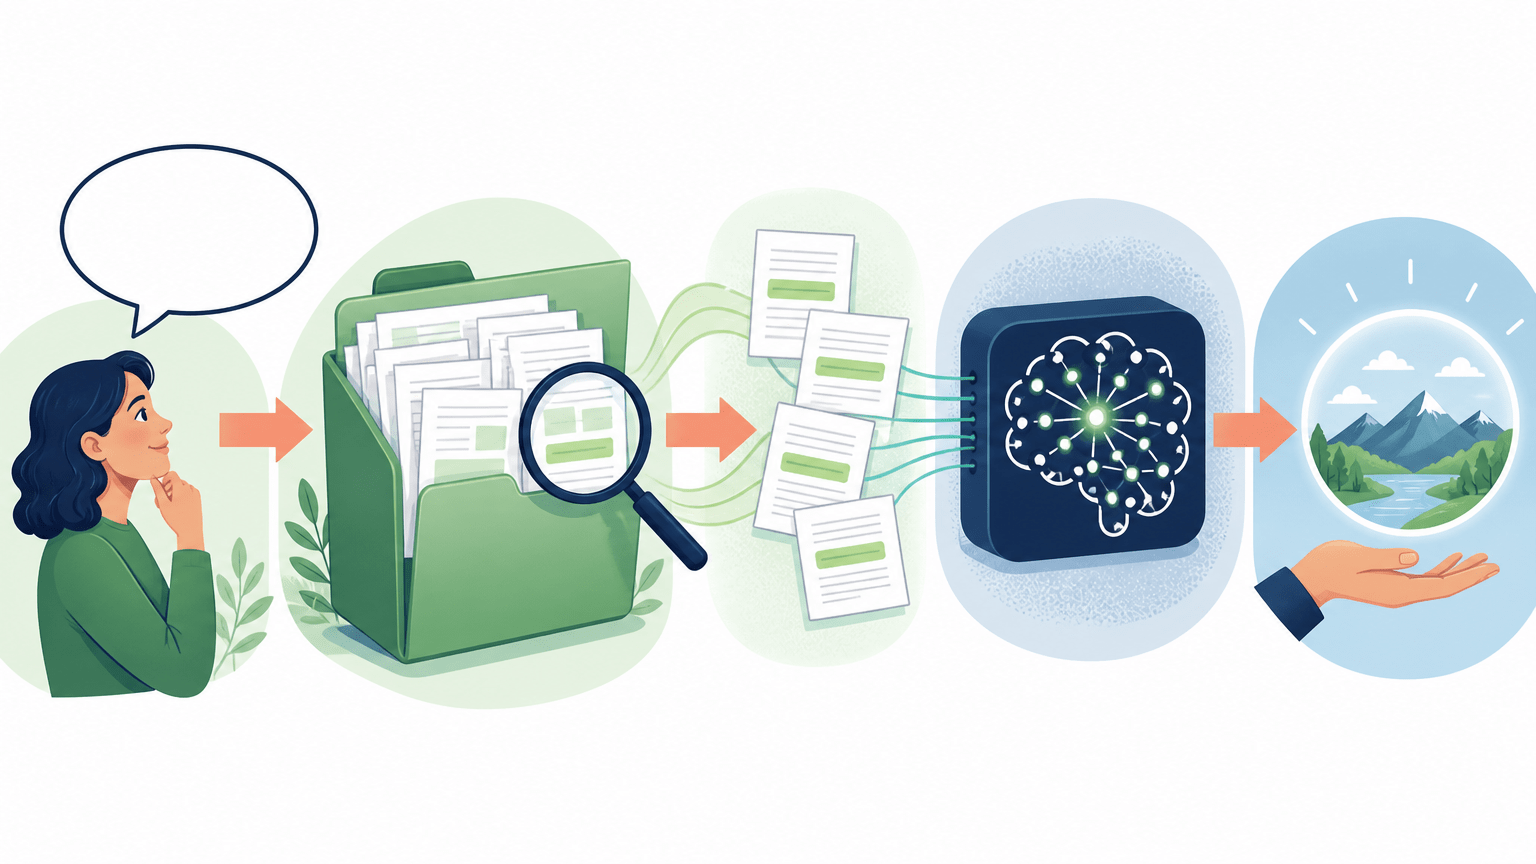
Aquí está el malentendido más común: aportar un documento no es necesariamente entrenar a la IA.
En lenguaje llano, el sistema funciona así: haces una pregunta, un buscador rastrea fragmentos relevantes en una colección de documentos y se los pasa al modelo junto con tu pregunta. El modelo redacta la respuesta con ese material delante. Los pesos del modelo no cambian. A esta técnica se la suele llamar RAG, pero basta con la imagen del bibliotecario que te trae tres páginas marcadas antes de responder.
Los servicios en la nube lo plantean igual. La documentación de grounding con Vertex AI Search de Google Cloud describe conectar un modelo a sitios o conjuntos de documentos, y deja claro que hace falta una fuente de datos y los permisos correspondientes. No es magia: alguien tiene que decir dónde están los documentos y quién puede leerlos.
Nivel 5: ajuste del modelo
Es el peldaño más alto. Consiste en modificar parámetros del modelo, o añadirle piezas pequeñas llamadas adaptadores, usando ejemplos de entrenamiento. Requiere datos preparados, recursos, evaluación de resultados y compatibilidad con el modelo base.
Técnicas como las de PEFT de Hugging Face ajustan solo una pequeña cantidad de parámetros adicionales, lo que reduce lo que hay que entrenar. Pero reducir no es trivializar: sigue siendo un proyecto, no un botón. Y es un proceso distinto de consultar documentos, aunque a veces se confundan.
Un ejemplo hipotético: un asistente local con tus manuales
Imagina (es un escenario inventado para explicar, no un producto concreto) un asistente que se ejecuta en tu ordenador y consulta una carpeta con los manuales de tus electrodomésticos, facturas y apuntes. Ejecutar modelos en local es posible con proyectos como llama.cpp, que permite correrlos en tu propio dispositivo, y su servidor ofrece, en esa implementación, rutas como las de embeddings. Eso fundamenta el escenario local; no significa que cualquier aplicación local venga con memoria o consulta de documentos ya montadas.
Y aquí va una advertencia importante: una IA local no recuerda ni aprende automáticamente todo lo que le enseñas. Solo sabrá de tus documentos lo que la aplicación indexe y recupere en cada pregunta. Si le quitas esa pieza, vuelve a ser un modelo que no ha leído el manual de tu lavadora (que, seamos sinceros, tú tampoco).
Cómo debería comportarse un buen asistente así
- Mostrar de qué documento y de qué fragmento sale cada respuesta.
- Permitir reindexar la carpeta cuando cambias archivos.
- Permitir eliminar documentos del índice.
- Responder «no lo encuentro en tus documentos» cuando no hay respaldo, en lugar de improvisar.
Actualizar o retirar información
Si sustituyes un manual por una versión nueva, el asistente no se entera solo: hay que reindexar. Y si retiras un documento, conviene comprobar que desaparece también del índice y de cualquier copia que la aplicación haya guardado, no solo de la carpeta. Según nuestra lectura, esta es una ventaja práctica de consultar documentos frente al ajuste del modelo: cambiar un archivo es mucho más sencillo que repetir un entrenamiento. Ahora bien, cómo se borra de verdad depende de la aplicación, así que verifícalo con una prueba: pregunta por algo que solo estaba en el documento retirado.
Comprobar el respaldo documental
Una respuesta bien redactada no es una respuesta verificada. Antes de fiarte, haz esto:
1. Abre el fragmento que cita y lee si dice lo que la IA afirma.
2. Fíjate en cifras, fechas y condiciones: es donde más se cuela el error.
3. Pregunta por algo que sabes que no está en tus documentos. Si responde con aplomo en vez de decir que no lo encuentra, desconfía.
Local no significa blindado
Ejecutar el asistente en tu equipo puede reducir lo que se envía a terceros, pero no garantiza por sí solo seguridad, borrado ni ausencia de registros. Revisa qué aplicación usas, qué permisos le das a la carpeta y qué extensiones o complementos tiene activados. Tus manuales serán inofensivos; tus facturas, quizá no tanto.
Resumen rápido
- Instrucciones: reglas que puedes cambiar sin tocar el modelo.
- Conversación: lo que hay a mano en la sesión; puede no sobrevivir a la siguiente.
- Memoria: depende de la aplicación, de sus controles y de lo que guarde.
- Documentos: se consultan, no se entrenan; exigen índice y respaldo visible.
- Ajuste: cambia el modelo y exige datos, recursos y evaluación.
Para ampliar información
- OpenAI: Memory FAQ
- Google Cloud: grounding con Vertex AI Search
- llama.cpp: README
- llama.cpp: servidor
- Hugging Face: PEFT
- En LedSolEo: Cómo funciona la IA generativa y Cómo dar instrucciones a una IA y comprobar sus respuestas
Redacción LedSolEo