La memoria de los agentes de IA: cómo recuerdan y qué pueden olvidar
Redacción LedSolEo
Si le has contado algo a un asistente de IA y al día siguiente parecía no saber quién eras, ya has tocado el tema de este artículo. Un agente puede «recordar», pero lo que llamamos memoria es una mezcla de archivos, bases de datos y reglas sobre qué se le enseña al modelo y cuándo.
Qué es la memoria de un agente
Una conversación normal vive dentro de un hilo: se tiene en cuenta lo dicho mientras cabe. Un agente, en cambio, actúa, usa herramientas y trabaja por pasos (lo repasamos en qué es un agente frente a un chatbot), así que necesita conservar lo que hizo, lo que aprendió de ti y lo que queda pendiente.
Recordar no es comprender ni tener conciencia. La memoria de un agente es almacenamiento y recuperación de información, no una facultad humana. Se parece más a la libreta de la compra que a un cerebro: apunta lo que le dices, pero no entiende por qué necesitas leche a las once de la noche.
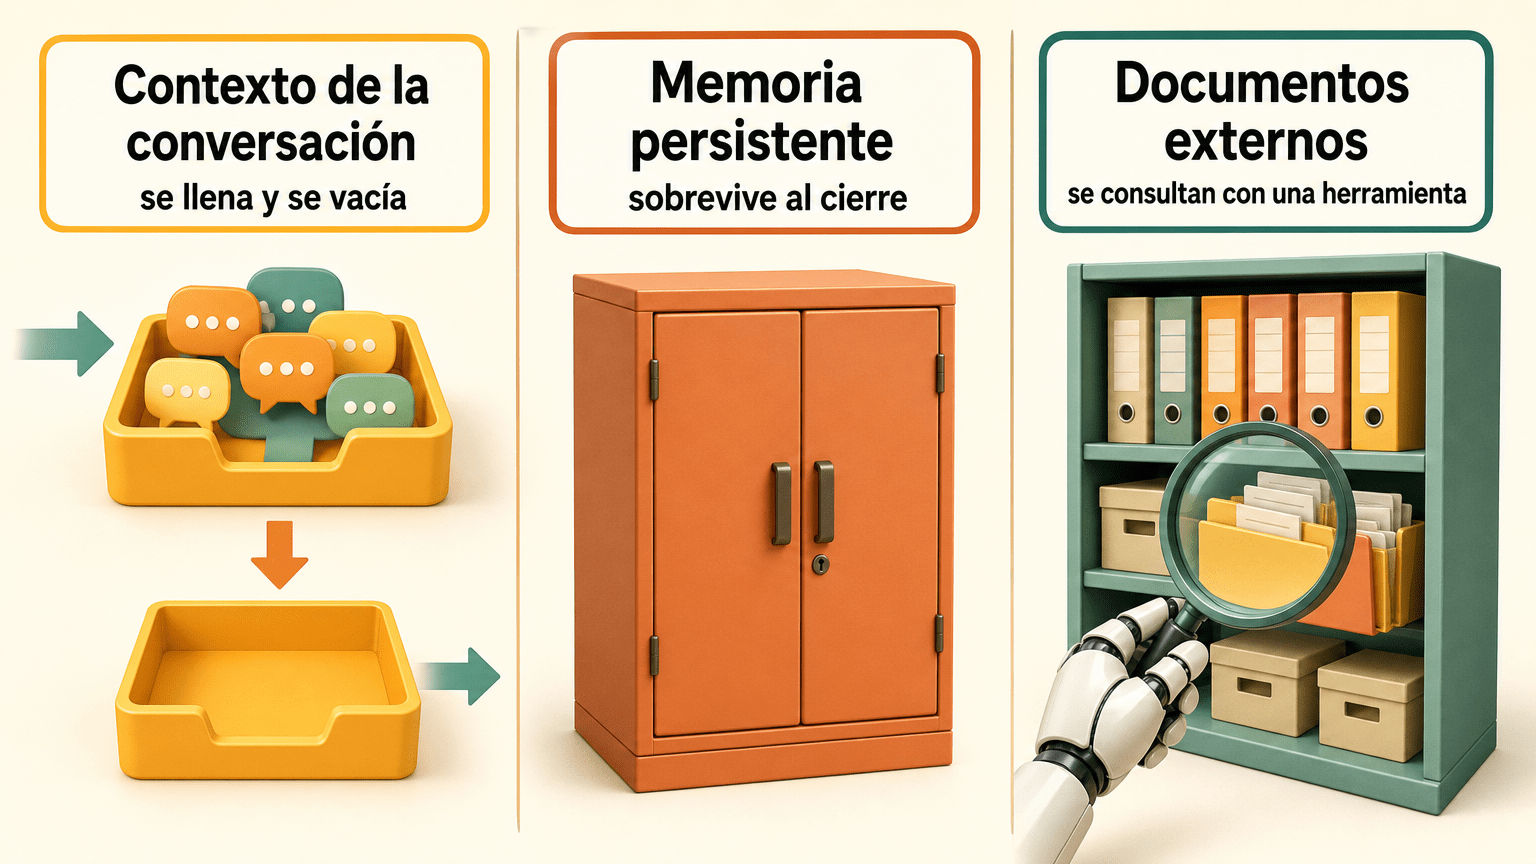
Conviene distinguir tres cosas que se confunden a menudo:
- Memoria almacenada: lo que se guarda fuera del modelo, en archivos, bases de datos o índices.
- Contexto entregado: lo que se le da al modelo en una consulta concreta.
- Información recuperada: lo que el agente va a buscar con herramientas cuando lo necesita.
Cuatro piezas que conviene no mezclar
El contexto es lo que el modelo tiene delante ahora. Según Anthropic, es el conjunto de tokens que se incluyen al consultarlo: instrucciones, herramientas, datos externos e historial. No es infinito: un agente que trabaja en bucle genera cada vez más datos que hay que ir refinando.
El historial es el registro de lo ocurrido: mensajes, respuestas y llamadas a herramientas. El SDK de agentes de OpenAI lo recupera antes de cada turno, lo antepone a la entrada nueva y guarda lo nuevo después.
La memoria persistente son notas que sobreviven al cierre de la conversación. La herramienta de memoria de Claude es un ejemplo: el agente crea, lee, actualiza y borra archivos que persisten entre sesiones.
Los documentos consultables son manuales o apuntes que el agente consulta con herramientas; estándares como el Model Context Protocol sirven para conectarlo con fuentes externas. No son memoria interna: están ahí fuera y se consultan. Y aquí no repetimos qué separa la inteligencia de la identidad de un agente.
Memoria a corto y a largo plazo
La memoria a corto plazo está limitada a un hilo o sesión; la de largo plazo persiste entre conversaciones. LangChain los guarda como documentos JSON organizados por espacio de nombres y clave, como carpetas y archivos, y admite almacenes como PostgreSQL o Redis.
Que algo sea de corto o largo plazo depende de dónde se guarde: en las sesiones de OpenAI, lo guardado en memoria se pierde al terminar el proceso, mientras que un archivo SQLite, Redis o el almacenamiento en el servidor persisten.
Cómo se guarda y se recupera un recuerdo
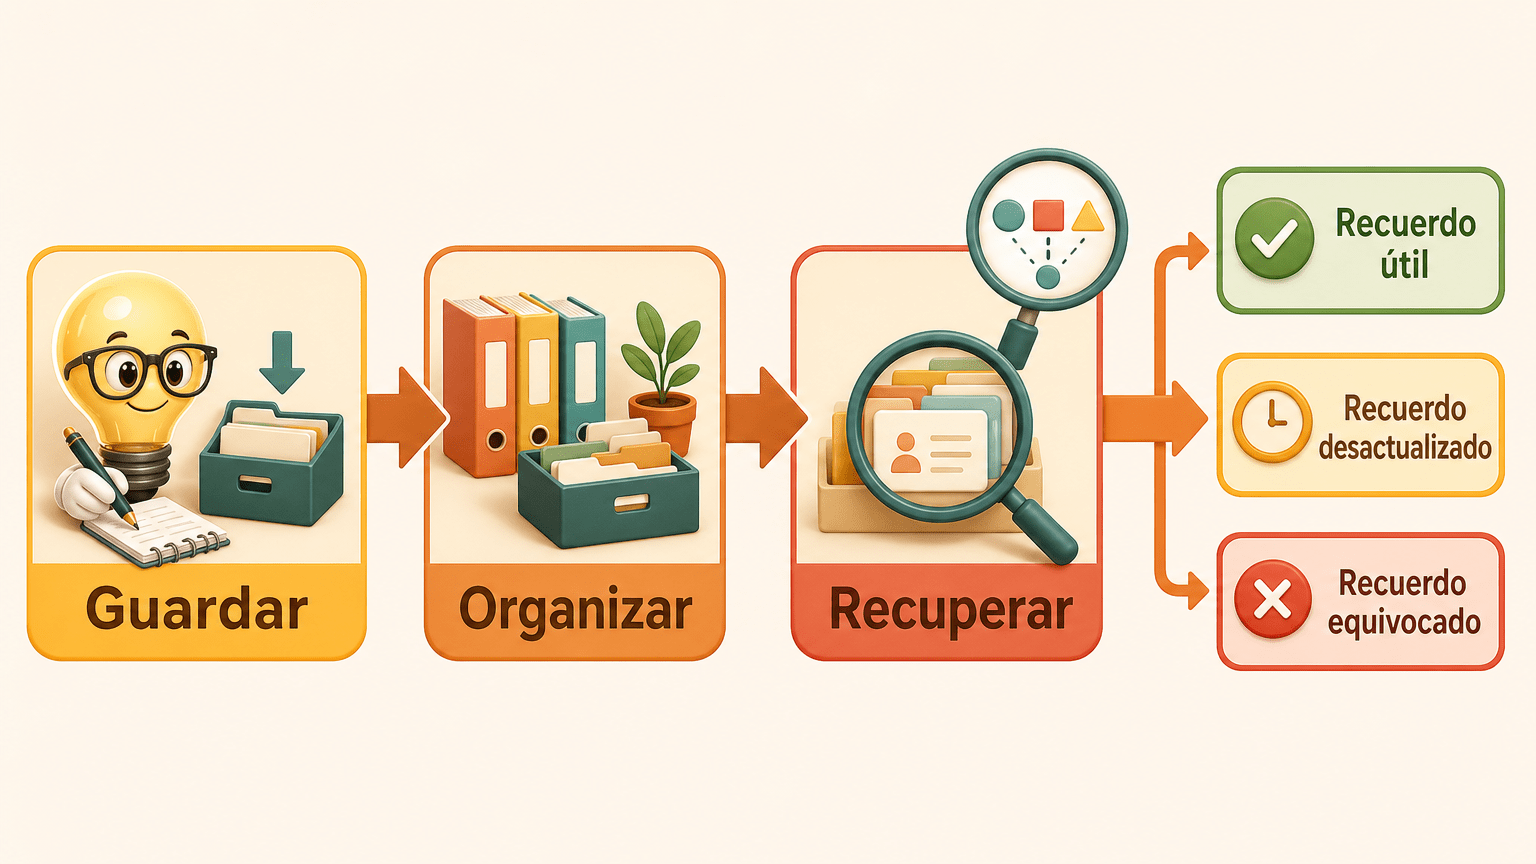
Una revisión académica resume tres operaciones: escribir (anotar lo que importa), gestionar (fusionar, resumir y olvidar lo irrelevante o desactualizado) y recuperar (traer lo útil en el momento oportuno). La documentación de Claude describe un patrón «justo a tiempo»: en vez de cargarlo todo de antemano, el agente anota lo que aprende y lo relee a demanda.
Aquí entra la búsqueda semántica: un modelo convierte los textos en vectores (embeddings), representaciones matemáticas que sitúan cerca lo parecido. Al consultar, se buscan los vectores más cercanos a la pregunta, y las bases de datos vectoriales están hechas para eso. También existe la búsqueda híbrida, que combina similitud y palabras clave, como explica Microsoft Learn.
No son obligatorias ni universales: hay memorias hechas con simples archivos de texto, con bases de datos normales o con otros índices. La herramienta de memoria de Claude, por ejemplo, trabaja con un directorio de archivos. Un detalle práctico: en la generación aumentada por recuperación (RAG), la base de conocimiento se actualiza sustituyendo el índice, sin reentrenar el modelo.
Seguir trabajando después de cerrar la conversación
El truco es que el estado vive fuera del modelo: una primera sesión puede crear un registro de progreso o una lista de tareas, y las siguientes empiezan leyéndolos. El modelo no «se acuerda»: lee sus notas. OpenAI describe cuatro estrategias para llevar el estado al turno siguiente: el historial en tu aplicación, una sesión con tu almacenamiento, un identificador de conversación del servidor o el identificador de la respuesta anterior. Es una decisión de arquitectura; para verlo aplicado, un agente personal persistente.
Qué ocurre al cambiar de modelo
Depende de dónde esté. La memoria que vive fuera del modelo (archivos, bases de datos, índices) puede conservarse si la arquitectura lo permite, porque el nuevo modelo puede leer lo mismo; el contexto de cada consulta hay que reconstruirlo. La memoria «dentro» del modelo, la paramétrica, que se logra con ajuste fino o edición de conocimiento, está atada a ese modelo. La revisión académica citada distingue entre memoria textual (explícita) y paramétrica (implícita).
Por qué un agente olvida, confunde o se queda anticuado
Es un análisis de esta redacción, no una lista oficial de fallos:
- Ventana limitada: si el contexto se llena, algo tiene que salir.
- Resúmenes que pierden detalle: la compactación resume la conversación al acercarse al límite y puede llevarse por delante un matiz.
- Recuperación que trae lo que no toca: pides algo del lavavajillas y el buscador trae el manual de la lavadora.
- Datos viejos disponibles: si nadie los revisa ni los borra, siguen ahí y pueden parecer vigentes.
- Memoria ensuciada: una entrada no fiable, o un cambio hecho directamente en la base de datos, contamina lo que el agente cree saber.
Por eso conviene comprobar las respuestas en lugar de fiarse de que «ya lo sabe».
Privacidad, permisos y control
En la herramienta de memoria de Claude, el modelo pide operaciones y las ejecuta tu aplicación; el almacenamiento es tuyo (disco, base de datos, nube o cifrado). De ahí, varias responsabilidades:
- Autorizar por sesión: el identificador de sesión selecciona el historial, pero no autentica a nadie, así que la aplicación debe autorizar cada acceso y proteger la base de datos y sus copias.
- Rutas maliciosas: hay que restringir las operaciones al directorio de memoria y protegerse frente a rutas con `../`.
- Límites de tamaño: conviene acotar el tamaño de los archivos.
- Datos sensibles: el modelo suele negarse a guardarlos; conviene validarlos y eliminarlos antes de almacenar.
- Permisos: si el agente actúa, importa qué puede hacer: lo vimos en cómo dar permisos sin perder el control. Y si los datos no deben salir de tu equipo, existe la IA local.
Sobre la eliminación, el artículo 17 del RGPD reconoce el derecho de supresión cuando concurran ciertos supuestos, pero no es absoluto: hay excepciones, como la libertad de expresión o una obligación legal. La seguridad y la privacidad siguen siendo problemas abiertos en este campo.
Ejemplos cotidianos y futuro
Imagina un asistente que, al preparar un viaje, consulta tus notas de preferencias y recupera el itinerario de la semana pasada, o uno de trabajo que cada mañana lee su lista de tareas.
Los agentes generativos simulados en un entorno de juego combinan memoria, reflexión y recuperación dinámica: su comportamiento puede parecer creíble sin que eso implique conciencia. Como expectativa, cabe esperar que la memoria de los asistentes personales y profesionales siga evolucionando con más control para el usuario; no hay cifras ni promesas detrás de esto.
Para ampliar información
Fuentes externas:
- Claude Docs: herramienta de memoria
- Anthropic: ingeniería de contexto eficaz para agentes
- OpenAI Agents SDK: sesiones
- OpenAI: cómo ejecutar agentes
- LangChain: memoria a largo plazo
- MemGPT: modelos de lenguaje como sistemas operativos (arXiv)
- Revisión sobre los mecanismos de memoria en agentes basados en modelos de lenguaje (arXiv)
- Generación aumentada por recuperación, RAG (arXiv)
- Agentes generativos: simulacros interactivos de comportamiento humano (arXiv)
- Microsoft Learn: introducción al índice vectorial
- RGPD: texto del Reglamento (UE) 2016/679, con el artículo 17 sobre supresión
- Model Context Protocol: introducción
Más en LedSolEo:
- Cómo personalizar una IA con tus instrucciones, preferencias y documentos
- Un agente personal persistente que trabaja por ti
- Cómo dar permisos a un agente de IA sin perder el control
- Qué es un agente de IA y en qué se diferencia de un chatbot
- IA local: qué significa tener una inteligencia artificial en tu ordenador
- Cómo dar instrucciones a una IA y comprobar sus respuestas