IA local: qué significa tener una inteligencia artificial en tu ordenador
Local frente a nube: dónde ocurre el cálculo
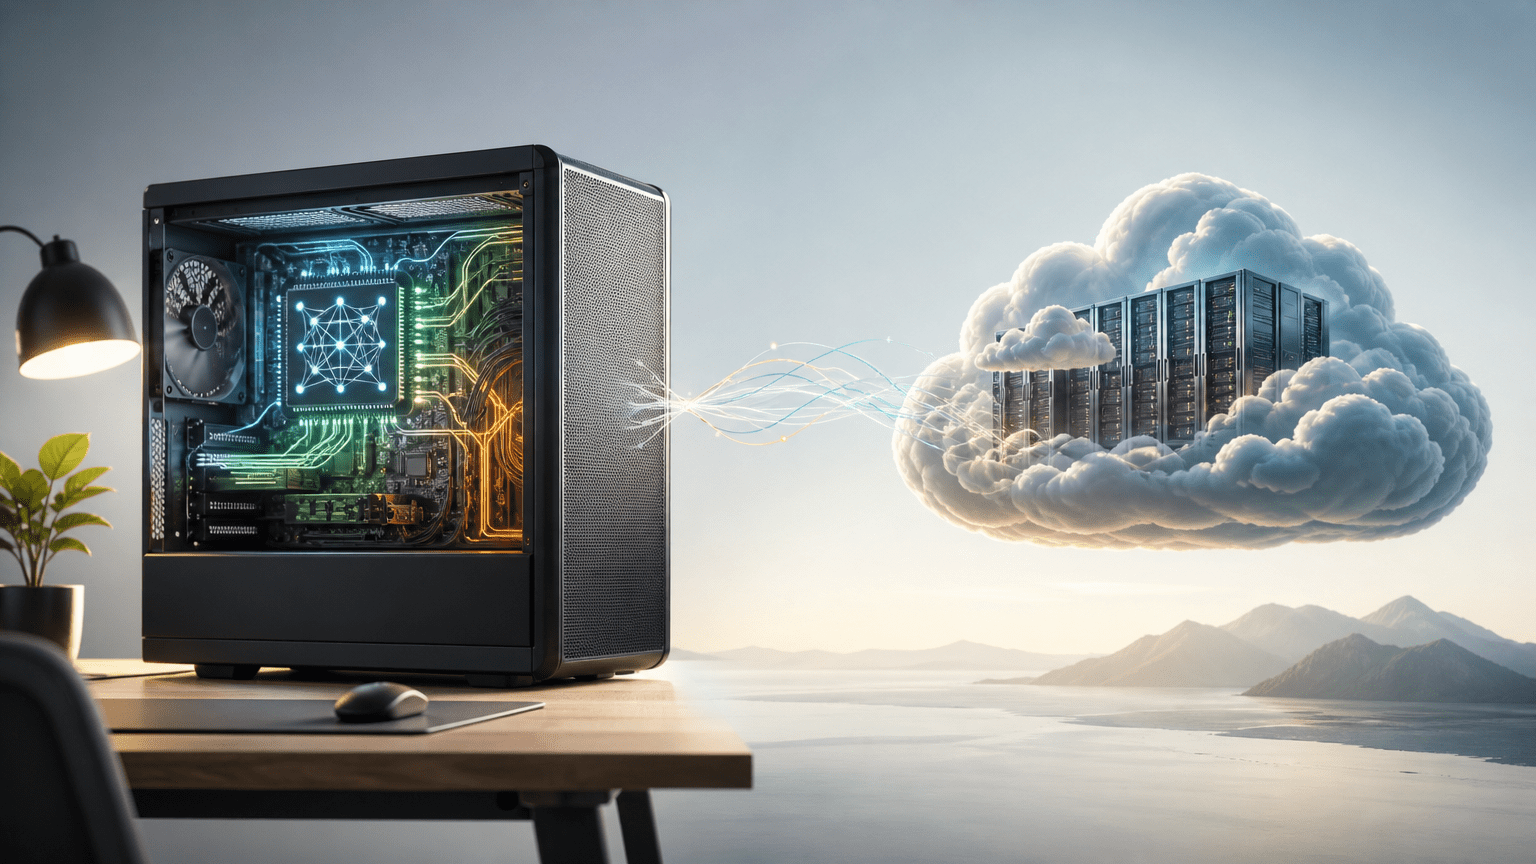
La diferencia es de lugar. En una IA local, el cálculo principal del modelo ocurre en tu propio dispositivo. En una IA en la nube, lo que escribes viaja a un servicio remoto, se procesa allí y vuelve la respuesta.
Es como la diferencia entre cocinar en casa y pedir a domicilio. En ambos casos acabas con la cena en la mesa, pero cambia quién tiene la cocina, quién pone los ingredientes y cuánto tardas en tener hambre otra vez.
Si quieres entender primero cómo genera texto un modelo, tienes una explicación en Cómo funciona la IA generativa. Y si aún mezclas IA, aprendizaje automático y aprendizaje profundo, en IA, machine learning y deep learning: diferencias con ejemplos se aclara.
Qué se descarga realmente
Un modelo es, ante todo, un archivo
Los modelos compatibles con llama.cpp se almacenan localmente, y el formato que usa este proyecto es GGUF. La descarga y la licencia dependen de cada modelo, así que no hay una regla común para todos. Fuente: llama.cpp: modelos
Y un programa que lo ejecuta
El archivo del modelo no hace nada por sí solo. Necesita un programa que lo cargue y haga los cálculos para responder. llama.cpp es un ejemplo: un proyecto de inferencia que, según su documentación, admite ejecución en CPU, en GPU y de forma híbrida. Fuente: llama.cpp: README oficial
Almacenamiento, RAM y GPU: tres piezas, tres papeles
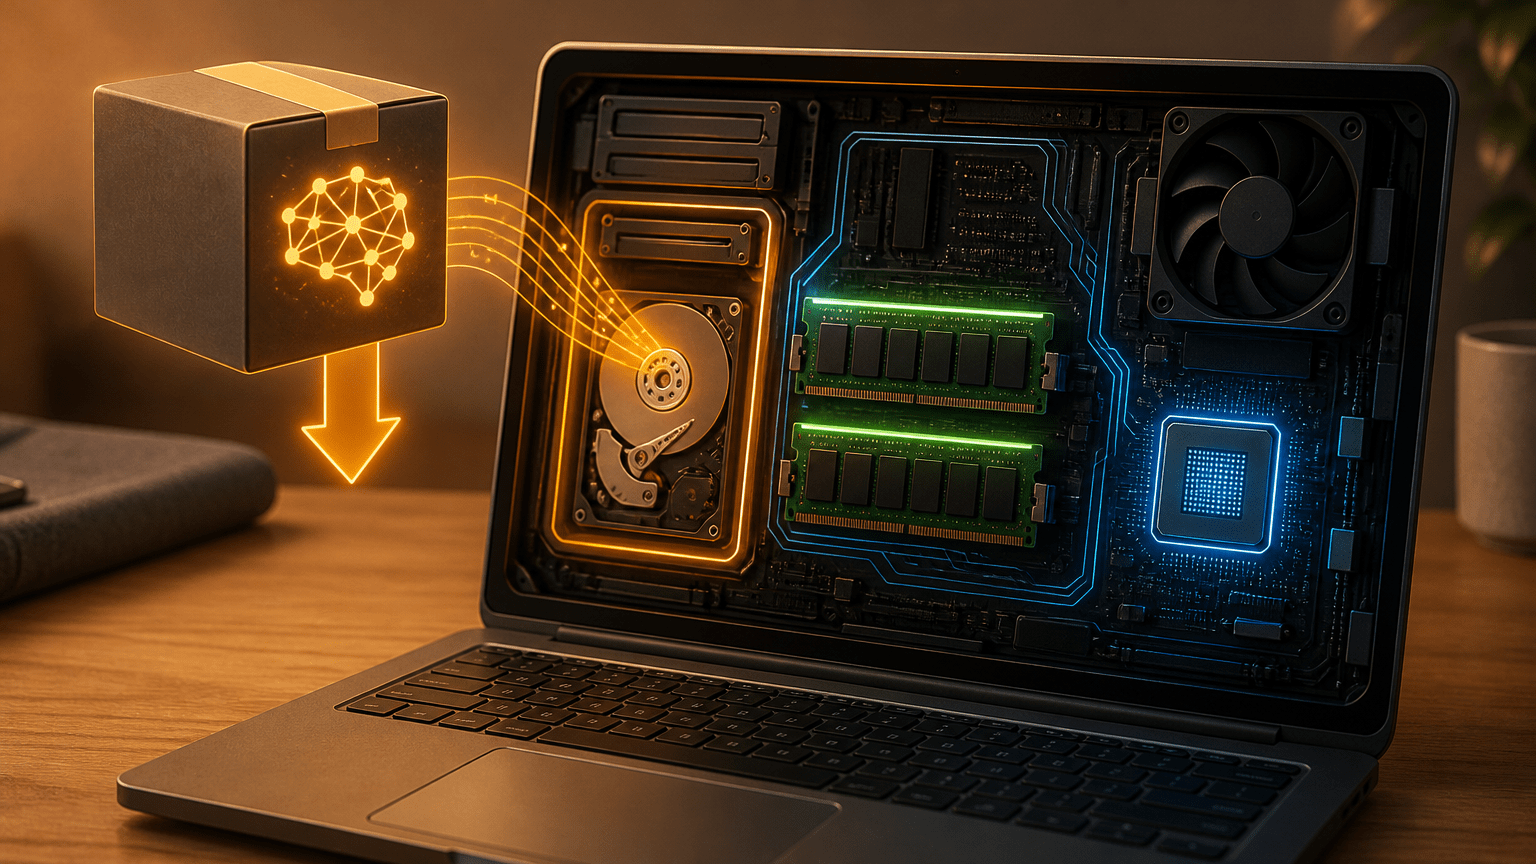
Para no perderse, conviene separar tres recursos:
- Almacenamiento: es donde vive el archivo del modelo cuando no lo usas. Cuanto más grande es el modelo, más espacio ocupa. La documentación de Ollama para Windows indica que guardar modelos puede requerir decenas o cientos de GB, aunque eso no es una cifra universal: depende de cuáles descargues. Fuente: Ollama en Windows
- RAM: es la memoria de trabajo. Para responder, el modelo tiene que cargarse en memoria. La FAQ de Ollama documenta ese comportamiento de modelos cargados en memoria, y lo tomamos como ejemplo de una aplicación concreta, no como regla para todas. Fuente: Ollama: preguntas frecuentes
- GPU y CPU: son quienes hacen los cálculos. La GPU puede acelerar el proceso y algunos programas reparten el trabajo entre CPU y GPU. Fuente: llama.cpp: README oficial
Existe además la cuantización, una técnica que reduce el uso de memoria del modelo. Fuente: llama.cpp: README oficial Dicho a lo sencillo: es comprimir el modelo para que quepa en equipos más modestos, normalmente a cambio de ciertos compromisos. No damos cifras de hardware porque dependen del modelo, del programa y de lo que quieras hacer.
Un detalle práctico: el disco suele ser el primero en enterarse de que has descargado «solo un modelo más».
¿Funciona sin Internet?
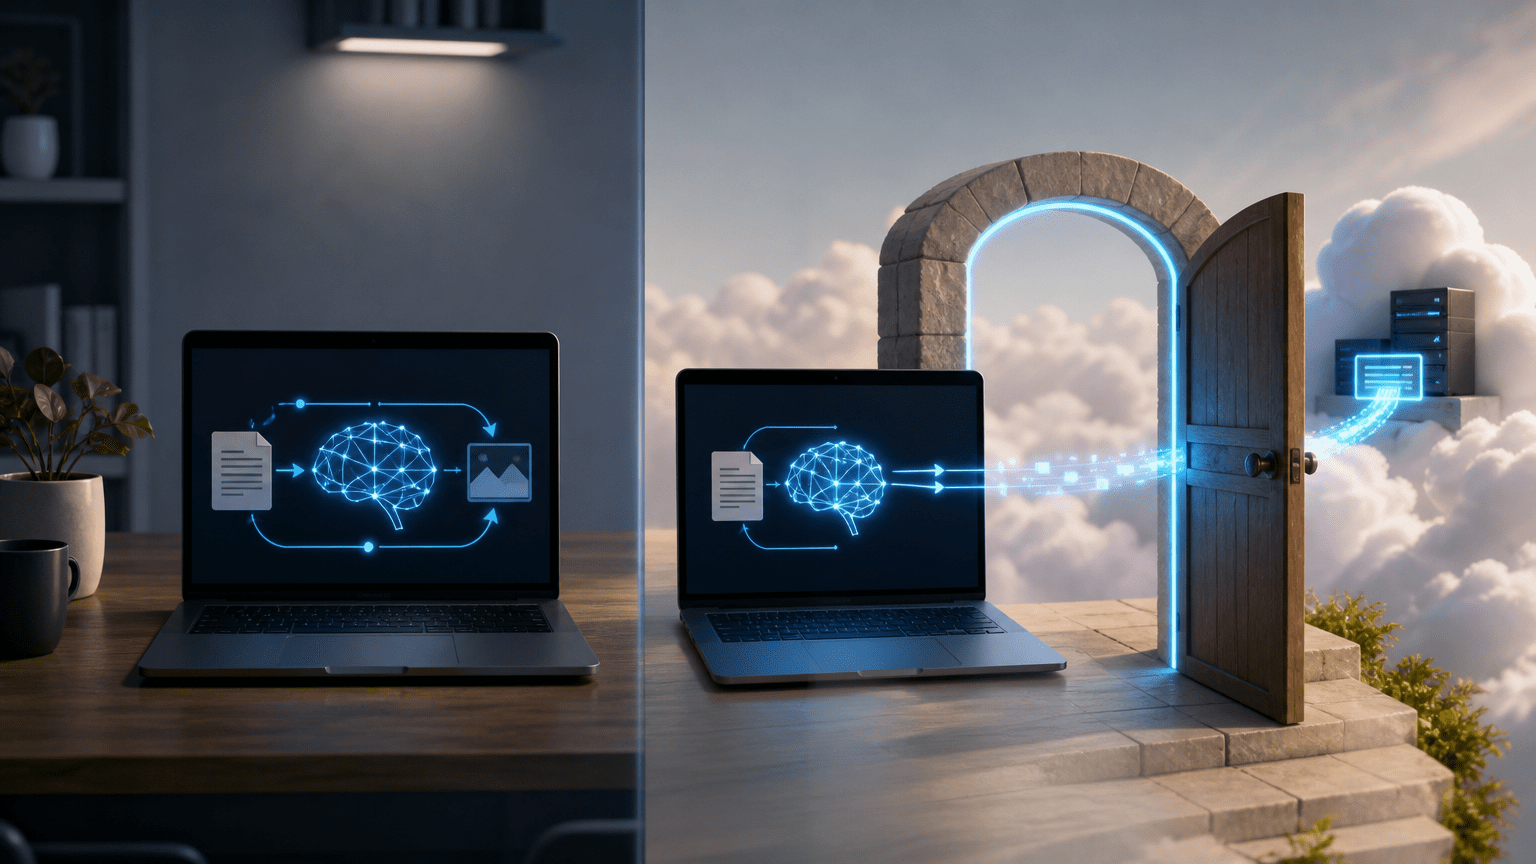
Puede funcionar, siempre que el programa, el modelo y los recursos necesarios ya estén en tu equipo. Sin red no podrás descargar modelos nuevos ni actualizaciones. Y todo lo que dependa de un servicio externo, como ciertas funciones o aplicaciones híbridas, puede requerir conexión.
Es decir: «sin Internet» es posible, pero no es una propiedad automática de toda aplicación llamada local.
Local no significa automáticamente privado
llama.cpp incluye un servidor local con API compatible con OpenAI y con funciones opcionales. Fuente: llama.cpp: servidor La conclusión prudente es que no hay que dar por hecho que una interfaz local carece de red.
Otro ejemplo: Ollama es una aplicación asociada a modelos locales, y su documentación describe también una modalidad en la nube. Fuente: Ollama Cloud Esto no señala ningún defecto. Sirve para ver que una misma aplicación puede tener partes locales y partes remotas.
Que el cálculo sea local no garantiza que la aplicación no envíe telemetría, consultas, actualizaciones o llamadas de herramientas. Para saberlo, lo razonable es leer la documentación y la configuración de cada programa, y si hace falta comprobar el tráfico de red.
Pensad en el «casero» de las cartas de restaurante: ayuda a orientarse, pero no sustituye a leer los ingredientes.
Para qué sirve
Según el modelo y la aplicación, una IA local puede conversar, resumir textos, clasificar información, ayudar a redactar, traducir o analizar contenido. No todos los conjuntos ofrecen lo mismo: la comprensión de imágenes, el audio, el uso de herramientas y la velocidad dependen del modelo y de la aplicación concretos.
La utilidad depende también del tipo de trabajo. Para resumir un documento que ya tienes en el ordenador, redactar un borrador sin conexión o clasificar notas personales, una ejecución local puede resultar razonable. Para consultar información reciente, usar una herramienta externa o pedir una capacidad que el modelo descargado no incorpora, necesitarás conexión o un servicio adicional. El mismo ordenador puede combinar ambos caminos: una parte del trabajo ocurre localmente y otra sale a Internet. Por eso conviene preguntar, tarea por tarea, qué datos entran, qué modelo responde y qué conexiones se activan. Esa pequeña auditoría evita convertir la palabra «local» en una etiqueta tranquilizadora que nadie ha comprobado.
Ventajas y limitaciones
Ventajas posibles
- Control sobre dónde se ejecuta el cálculo principal.
- Posibilidad de trabajar sin conexión, si todo está ya descargado.
- Libertad para elegir modelo y programa, dentro de lo que permitan sus licencias.
Son ventajas posibles, no garantías. Dependen de cómo esté configurado cada caso.
Limitaciones
- Tu equipo pone los límites de memoria, almacenamiento y velocidad.
- Local no equivale a igual de potente que un servicio en la nube: depende del modelo y del hardware.
- Hay que ocuparse de modelos, actualizaciones y configuración.
- Las licencias varían según el modelo.
Costes
Local no es sinónimo de gratis. Puede haber costes de hardware, electricidad, almacenamiento, tiempo de configuración, modelos o licencias y mantenimiento. La nube, por su parte, puede cobrar por uso o por suscripción. No damos precios: cambian según el servicio y el momento, y este artículo no recomienda compras. Lo útil es que compares tu caso con tus necesidades reales.
En resumen
Tener una IA en tu ordenador significa, sobre todo, que el cálculo principal se hace en tu equipo. A partir de ahí hay que mirar los detalles: qué modelo, qué recursos, qué aplicación y si hace llamadas externas. Local es una descripción de dónde se calcula, no un sello de privacidad, gratuidad o potencia.
Para ampliar información
- llama.cpp: README oficial
- llama.cpp: modelos
- llama.cpp: servidor
- Ollama: preguntas frecuentes
- Ollama en Windows
- Ollama Cloud
Redacción LedSolEo