Qué hay detrás de Claude: la infraestructura que hace posible la IA de Anthropic
Haces una pregunta, esperas unos segundos y aparece la respuesta. Parece algo ligero, casi etéreo, pero detrás hay chips, memoria, redes, electricidad y refrigeración repartidos entre varias empresas. Te explicamos qué piezas intervienen y separamos lo que ya funciona de lo que solo está acordado o previsto.
Claude es el producto; la infraestructura, el escenario
Claude es la familia de asistentes y modelos de Anthropic para conversar, escribir, programar y apoyar tareas de trabajo (Anthropic: Claude). Anthropic es la empresa que investiga, entrena y desarrolla esos sistemas, y se presenta como compañía de investigación y seguridad de IA (Anthropic: la empresa). Dario Amodei es cofundador y CEO, y la compañía lo sitúa al frente de la orientación de investigación y la visión estratégica (liderazgo). Lo que sigue, sin embargo, va de máquinas y de los equipos que las mantienen en marcha.
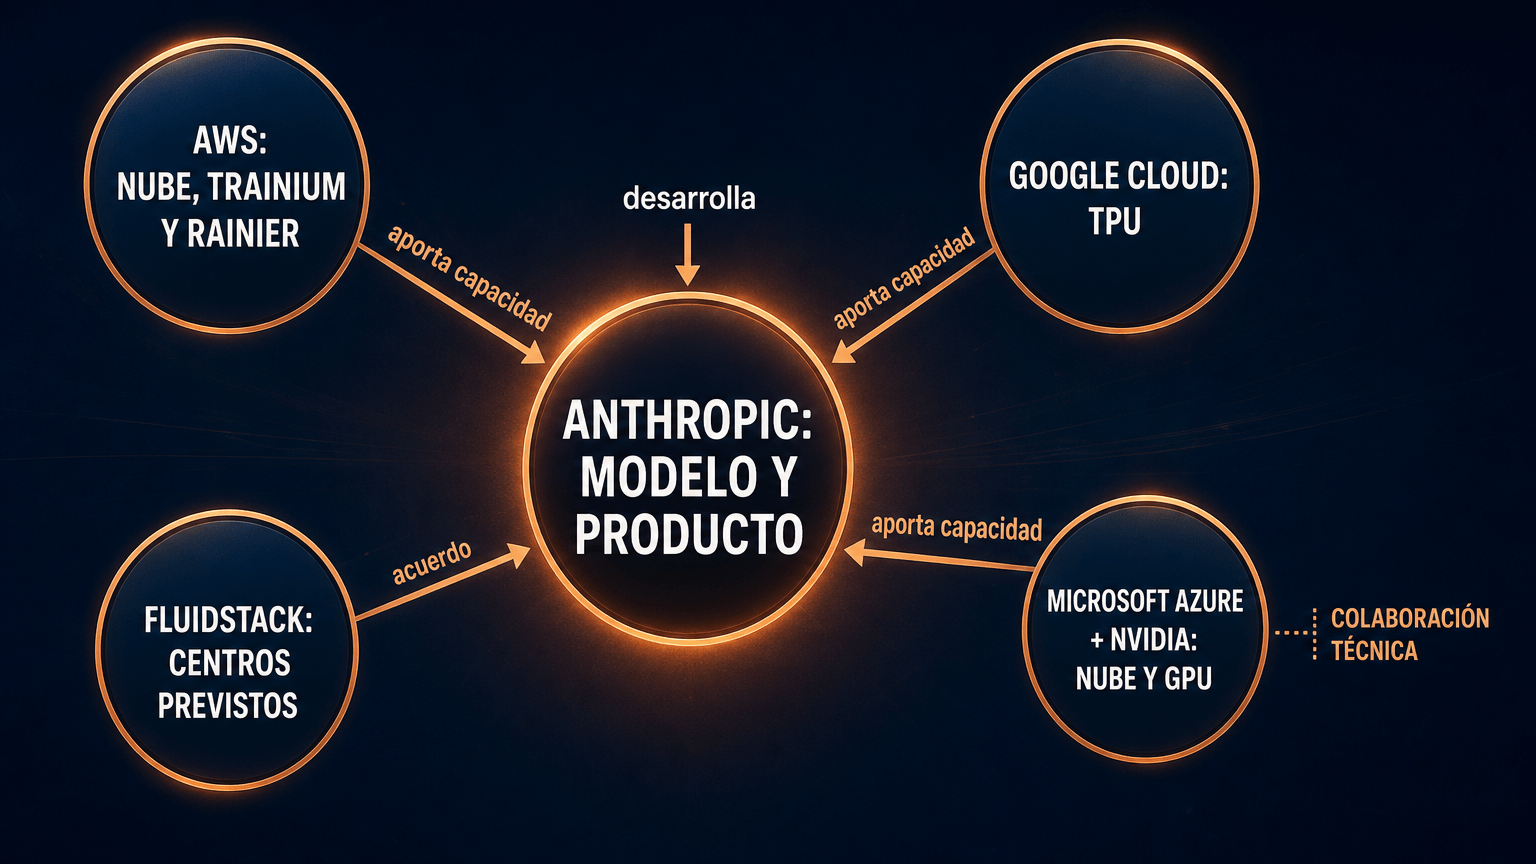
Esas máquinas no son todas de Anthropic. Amazon, Google, Microsoft, NVIDIA y Fluidstack aportan chips, nube, centros de datos, redes y capacidad. Un acuerdo de capacidad no convierte a Anthropic en dueña de las instalaciones: se parece más a un suministro que a unas escrituras. Para contrastar con OpenAI, consulta nuestro artículo sobre Stargate. Aquí nos centramos en Anthropic.
El viaje de una pregunta
Cuando escribes en Claude, o cuando una aplicación llama a su API, se envía una petición con mensajes estructurados y el modelo genera el siguiente mensaje (API de Messages). La documentación habla de messages, de max_tokens y de contadores como input_tokens y output_tokens. Un token es un fragmento de texto: el modelo lee tokens y produce otros, uno tras otro.
El recorrido, simplificado, es este: interfaz o API, petición con su contexto, servidores de inferencia, chips con su memoria y sus redes, tokens de salida y respuesta. «La nube» suena inmaterial, pero es un edificio lleno de cables y ventiladores; de algodón, nada.
Un matiz importante: no hay información pública sobre qué chip atiende una consulta concreta. Anthropic afirma que entrena y ejecuta Claude en AWS Trainium, Google TPU y NVIDIA GPU (Anthropic y Google/Broadcom). Por eso no conviene decir que «esta respuesta salió de tal chip».
Entrenar no es lo mismo que responder
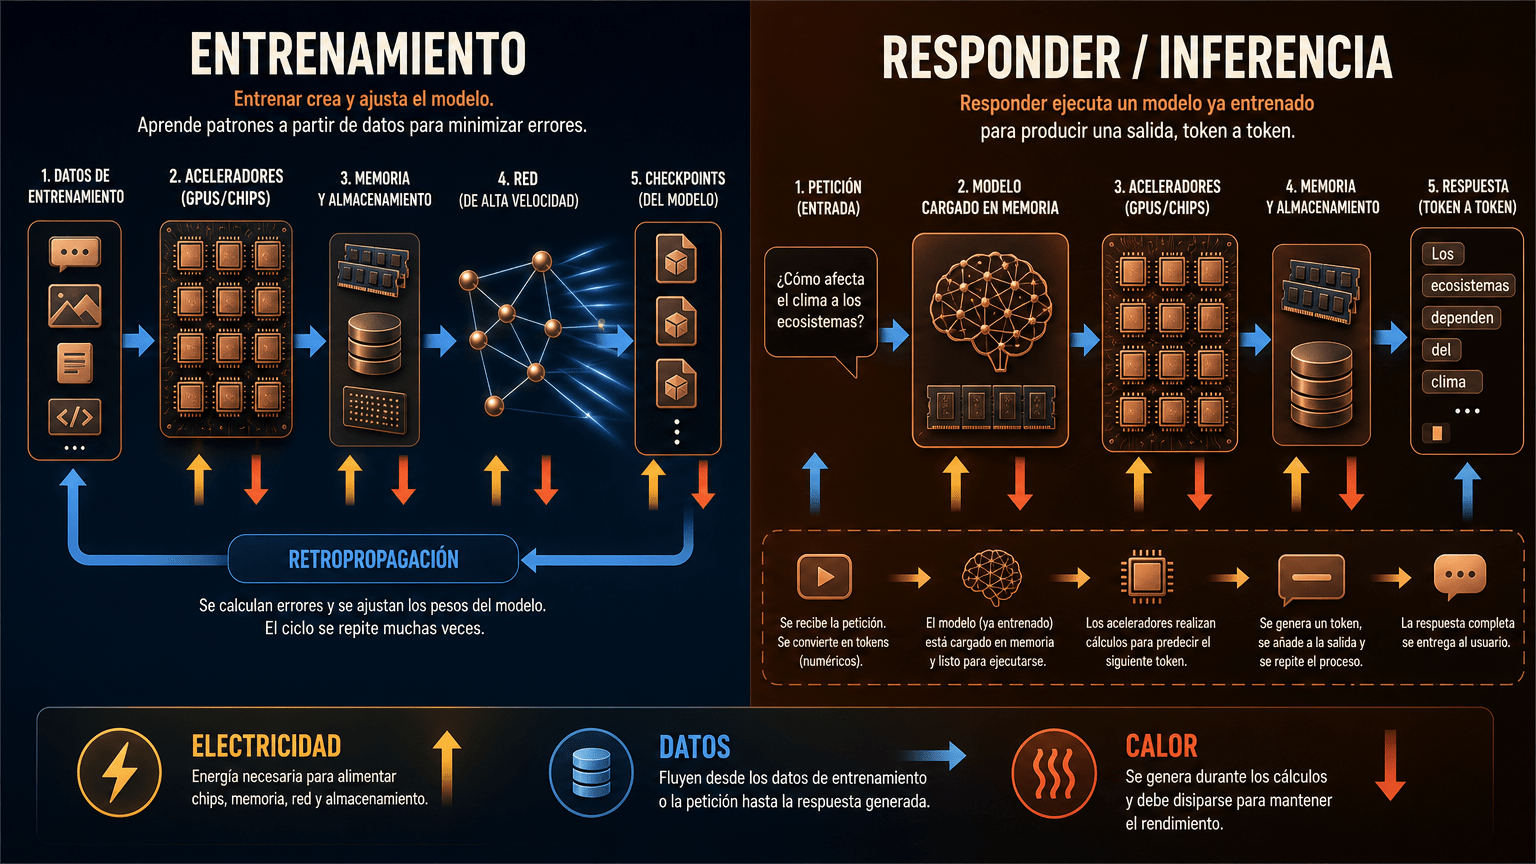
Entrenar es la fase larga: se procesan datos, se ajustan parámetros y se reparten cálculos entre aceleradores que intercambian resultados y guardan checkpoints.
Responder se llama inferencia: el modelo ya entrenado carga sus pesos, recibe la petición, calcula la salida token a token y la devuelve. Una respuesta suele costar menos que entrenar, pero a gran escala exige memoria, redes y disponibilidad para muchas solicitudes simultáneas. Es estudiar el temario frente a contestar el examen, salvo que aquí lo hacen millones de personas a la vez.
Una misma familia puede optimizarse para entrenar, responder rápido, razonar más tiempo o trabajar con un proveedor concreto.
Amazon: Trainium y Project Rainier
Anuncio (22-11-2024). Anthropic comunicó que AWS sería su principal proveedor de nube y socio de entrenamiento. Amazon anunció entonces 4.000 millones de dólares adicionales, 8.000 millones en total, y Anthropic empezó a trabajar con Annapurna Labs en Trainium y Neuron (anuncio).
Caso concreto. Anthropic indicó que Claude 3.5 Haiku podía usar Trainium2 para inferencia optimizada en Bedrock (anuncio). Esa evidencia se refiere a esa versión y a esa optimización, no a todas las versiones ni a todas las consultas.
Operativo. AWS comunicó que Project Rainier estaba online el 3 de noviembre de 2025, con casi 500.000 chips Trainium2 en varios centros de datos de EE. UU. y Anthropic entrenando y ejecutando inferencia allí. La fuente vigente de Anthropic afirma después que usa más de un millón de Trainium2 para entrenar y servir Claude (Anthropic y Amazon). Es un clúster construido por AWS en colaboración con Anthropic, no un campus propiedad de Anthropic.
Acuerdo y previsión. El 20 de abril de 2026, Anthropic anunció con Amazon un acuerdo de hasta 5 GW de nueva capacidad y más de 100.000 millones de dólares en tecnologías AWS durante diez años, con Graviton y Trainium2 a Trainium4. Se prevé casi 1 GW de Trainium2 y Trainium3 operativo al terminar 2026. Anthropic añade que usa más de un millón de Trainium2 para entrenar y servir Claude (anuncio). Esa cifra no se suma a los casi 500.000 de Rainier, porque son fechas y alcances distintos. Y los 5 GW son un acuerdo, no capacidad ya instalada ni consumo real.
Google, Microsoft y NVIDIA
Google. El 23 de octubre de 2025, Anthropic anunció hasta un millón de TPUs y más de un gigavatio previsto para 2026 (anuncio). El 6 de abril de 2026 añadió un acuerdo con Google y Broadcom para varios gigavatios de TPUs de próxima generación desde 2027 (anuncio). Son anuncios con horizontes distintos y posibles solapamientos: no se suman. AWS sigue siendo el proveedor principal de nube y entrenamiento.
Microsoft y NVIDIA. El 18 de noviembre de 2025, Anthropic anunció Claude en Azure, 30.000 millones de dólares de capacidad contratada y hasta 1 GW adicional. La colaboración técnica menciona Grace Blackwell y Vera Rubin; Microsoft Foundry ofrecería Claude (anuncio). No demuestra que todas las versiones usen NVIDIA ni que Anthropic posea Azure.
Fluidstack: centros pensados para Anthropic
El 12 de noviembre de 2025, Anthropic anunció 50.000 millones de dólares para centros con Fluidstack en Texas y Nueva York, diseñados para sus cargas y previstos para entrar en servicio durante 2026 (anuncio). Las fuentes consultadas no permiten declarar esos centros operativos ni conocer su potencia energizada: siguen siendo proyecto y previsión.
Chips, memoria, redes, electricidad y calor
Los aceleradores ejecutan multiplicaciones en paralelo y las CPU coordinan servicios. NVIDIA describe el GB200 NVL72 con 36 CPU Grace y 72 GPU Blackwell (NVIDIA), pero esa ficha no prueba que Claude lo use siempre. Amazon presenta Trainium como sistema integrado de chip, servidor, red, software y servicios (AWS): no es solo comprar un chip.
La memoria rápida mantiene pesos y activaciones cerca del chip, y el almacenamiento guarda modelos, datos y checkpoints. Las redes conectan aceleradores entre sí: en entrenamiento mueven gradientes y sincronización, y en inferencia llevan peticiones y respuestas. Si la red se atasca, los chips caros esperan.
Toda esa maquinaria consume electricidad. La potencia (MW, GW) es capacidad instantánea; la energía (MWh, TWh) es el consumo acumulado. Confundirlas es como creer que ir a 100 km/h equivale a haber recorrido 100 kilómetros. Por eso un acuerdo de 5 GW no demuestra 5 GW consumidos, ni un millón de chips significa un millón encendidos a la vez. Y la electricidad acaba como calor, que exige aire, líquido, intercambiadores y bombas; los aceleradores de alta densidad empujan hacia la refrigeración líquida.
Lo que sigue sin respuesta
Construir servidores no basta: hacen falta red eléctrica, generación, permisos, transformadores, agua y refrigeración. Programar chips distintos obliga a usar compiladores, kernels y herramientas diferentes, de modo que diversificar da resiliencia pero añade complejidad. Un clúster rinde lo que su componente más limitado. Los acuerdos expresan capacidad comprometida, no horas de uso, consumo ni rentabilidad. Y el anuncio de abril de 2026 con Amazon reconoce tensión de fiabilidad y rendimiento en picos de demanda.
Anthropic publica acuerdos y algunos datos de hardware, pero no un mapa completo de centros, consumo, asignación por modelo ni chip por consulta. En las fuentes consultadas tampoco hay una cifra consolidada de TWh consumidos. Son lagunas reales, y es mejor dejarlas señaladas que rellenarlas.
Para ampliar información
- Anthropic: la empresa y liderazgo
- Claude y API de Messages
- Anthropic y Amazon: Trainium y Trainium2 y destilación
- Anthropic y Amazon: Project Rainier y capacidad Trainium
- Google Cloud y TPUs y Google/Broadcom
- Microsoft, NVIDIA y Anthropic
- Inversión de 50.000 millones y Fluidstack
- NVIDIA GB200 NVL72 y AWS Trainium
- Contraste: Stargate: la infraestructura gigante que necesita la inteligencia artificial
Redacción LedSolEo