Jensen Huang y los chips de Nvidia: qué sostiene de verdad la revolución de la inteligencia artificial
Un chip famoso y una cadena muy larga
Cuando se habla de Nvidia y de su director ejecutivo, Jensen Huang, es fácil imaginar que la inteligencia artificial sale de un chip como una tostada sale de una tostadora. La realidad es menos vistosa y bastante más interesante: Nvidia es una pieza central de una cadena que incluye aceleradores, memoria, redes, software, fábricas, refrigeración y mucha electricidad.
Este artículo recorre esa cadena pensando en quien empieza. Por el camino separaremos tres cosas que a menudo se mezclan: los hechos comprobables, los anuncios de las empresas y las visiones de futuro. Las tres son útiles, pero no pesan lo mismo.
De la CPU al acelerador
Una CPU es el procesador generalista de un ordenador: flexible, buena para tareas variadas y para decidir qué hacer en cada momento. Una GPU, en cambio, reúne muchos núcleos más simples que trabajan en paralelo. Nacieron para los gráficos, pero encajan con el patrón central de las redes neuronales: multiplicar matrices enormes de números, una y otra vez. No es que la GPU «piense»; hace aritmética muy deprisa y en masa.
Los aceleradores actuales añaden unidades específicas, como los Tensor Cores, pensadas precisamente para esas multiplicaciones. Eso no convierte a la GPU en mejor que la CPU en todo: para tareas variadas y poco paralelizables, la CPU sigue siendo la herramienta adecuada. Piensa en un chef que sabe de todo frente a una cocina con cientos de ayudantes que solo saben cortar cebolla, pero la cortan a una velocidad asombrosa. Entrenar un modelo requiere muchísima cebolla.
Si quieres ver qué hace el modelo con todos esos cálculos, tenemos una explicación aparte sobre cómo funciona la IA generativa.
El cuello de botella: llevar los datos al cálculo
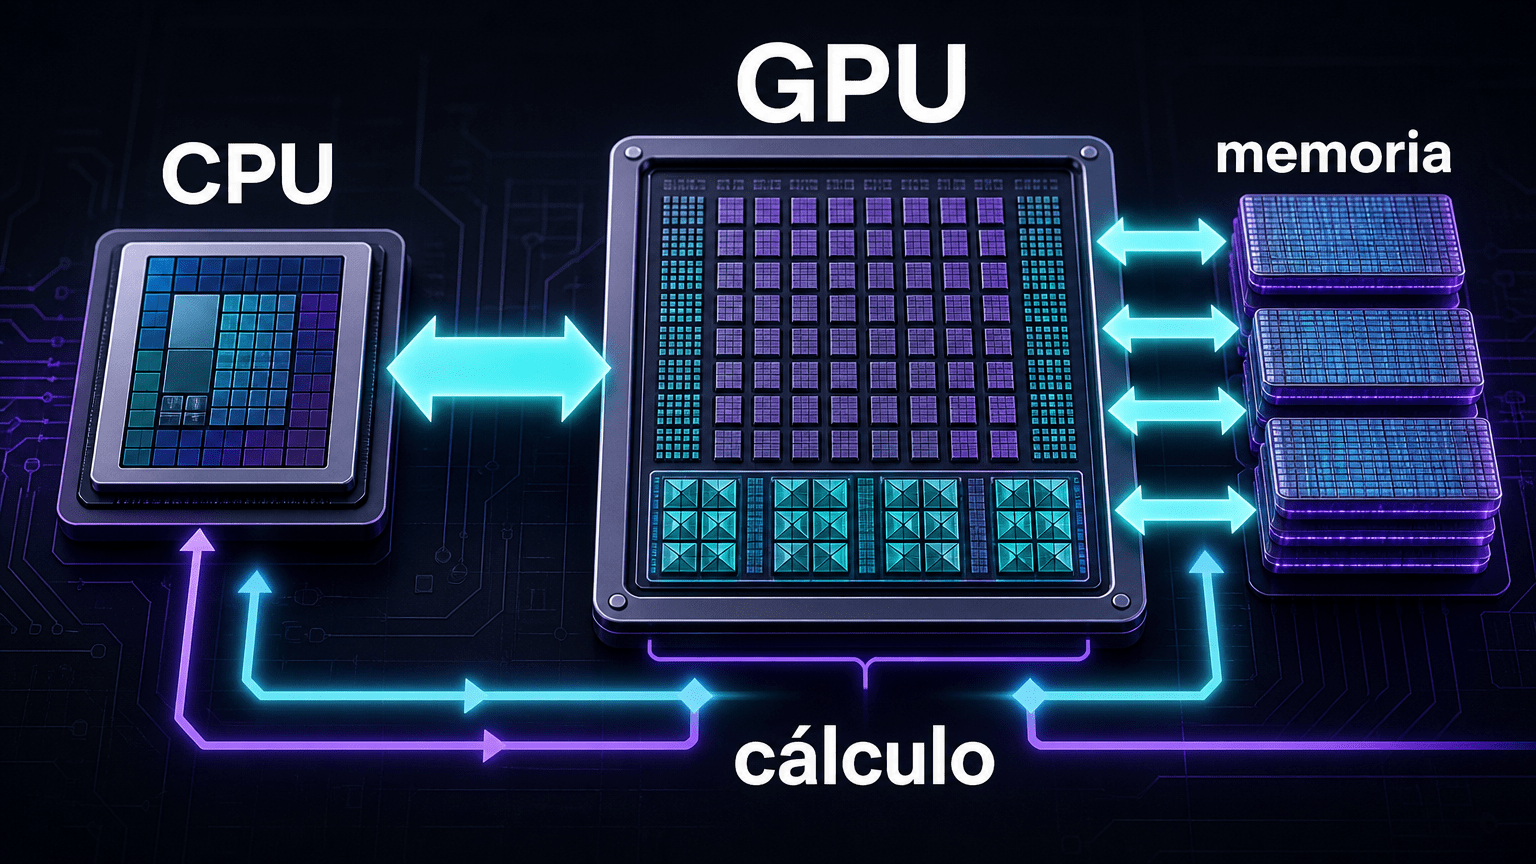
Calcular deprisa sirve de poco si los datos no llegan a tiempo. Un modelo grande debe viajar constantemente desde la memoria hasta las unidades de cálculo, y a menudo el atasco está en ese trayecto, no en las sumas y multiplicaciones.
Por eso existe la HBM, memoria de alto ancho de banda: se apila en capas y se coloca muy cerca del acelerador. Según la ficha de su HBM3E, Micron ofrece más de 1,2 TB/s por cubo, con versiones de 24 GB (8 capas) y 36 GB (12 capas) preparadas para producción. Son métricas del fabricante, y no eliminan otros límites: más memoria rápida también consume energía y cuesta dinero.
Quién diseña, quién fabrica y quién empaqueta
Nvidia diseña sus chips y coordina el producto, pero no fabrica directamente todo lo que lleva dentro. Fundiciones como TSMC producen chips y se encargan del empaquetado avanzado. TSMC describe CoWoS como una tecnología que integra procesadores y pilas de HBM en un empaquetado 2.5D, en producción desde 2012 y evolucionada para computación de alto rendimiento e IA. No es un tipo de litografía: es el arte de colocar y conectar piezas muy cerca unas de otras.
La HBM, además, la fabrican empresas de memoria. Después hay que integrarlo todo, probarlo y montarlo en servidores. Si un eslabón va lento, toda la cadena espera.
CUDA: la ventaja que no se ve en la foto
Parte del liderazgo de Nvidia no está en el silicio. Según la compañía, CUDA es la plataforma de software para usar sus GPUs en aplicaciones aceleradas: incluye toolkit, bibliotecas, compilador y herramientas, y se integra con C++, Python, Fortran y frameworks como PyTorch. Para un principiante, es el idioma con el que programadores y bibliotecas transmiten órdenes al chip.
Años de código, bibliotecas y conocimiento acumulado generan costes de migración: cambiar de plataforma puede implicar reescribir programas y reaprender herramientas. Eso explica parte de su posición, junto al hardware. Pero hablar de monopolio técnico absoluto sería exagerar: es una ventaja de ecosistema, no una ley de la física.
De chip suelto a sistema completo
Un solo acelerador no basta para los modelos grandes. Hay que conectar muchos entre sí. NVLink une aceleradores dentro de un sistema; redes como InfiniBand ayudan a comunicar sistemas distintos. La idea es que muchos chips cooperen como una sola máquina grande, y cuanto peor es la comunicación, más tiempo pasan esperando sin hacer nada útil.
Nvidia describe su arquitectura Blackwell con Tensor Cores, Transformer Engine y NVLink, con dominios de hasta 72 GPUs y escalado a 576 GPUs según la configuración. Su sistema DGX GB200 es un rack con 72 GPUs Blackwell y 36 CPUs Grace, hasta 13,4 TB de HBM3e, 576 TB/s de ancho de banda declarado y refrigeración líquida. Son especificaciones del fabricante, no un rendimiento universal: dependen de la configuración y de la tarea.
En marzo de 2025 Nvidia anunció Blackwell Ultra, con el sistema GB300 NVL72, dentro de su idea de «fábricas de IA». Eso es un anuncio: las cifras y los plazos son de la compañía y no equivalen a equipos instalados y funcionando en cualquier lugar.
Qué es (y qué no es) una fábrica de IA
La expresión suena a nave industrial con una inteligencia autónoma saliendo por una cinta transportadora. No es eso. Es una metáfora de infraestructura: un lugar que convierte electricidad, chips, datos y software en modelos y servicios.
Un rack no es una varita mágica: necesita energía, refrigeración líquida, espacio, red, operación y software. Si te interesa cómo se traduce esto en grandes proyectos, puedes leer nuestro análisis de Stargate y la infraestructura de la inteligencia artificial y el artículo sobre la infraestructura que hay detrás de Claude.
Electricidad y calor: la factura que no sale en la presentación
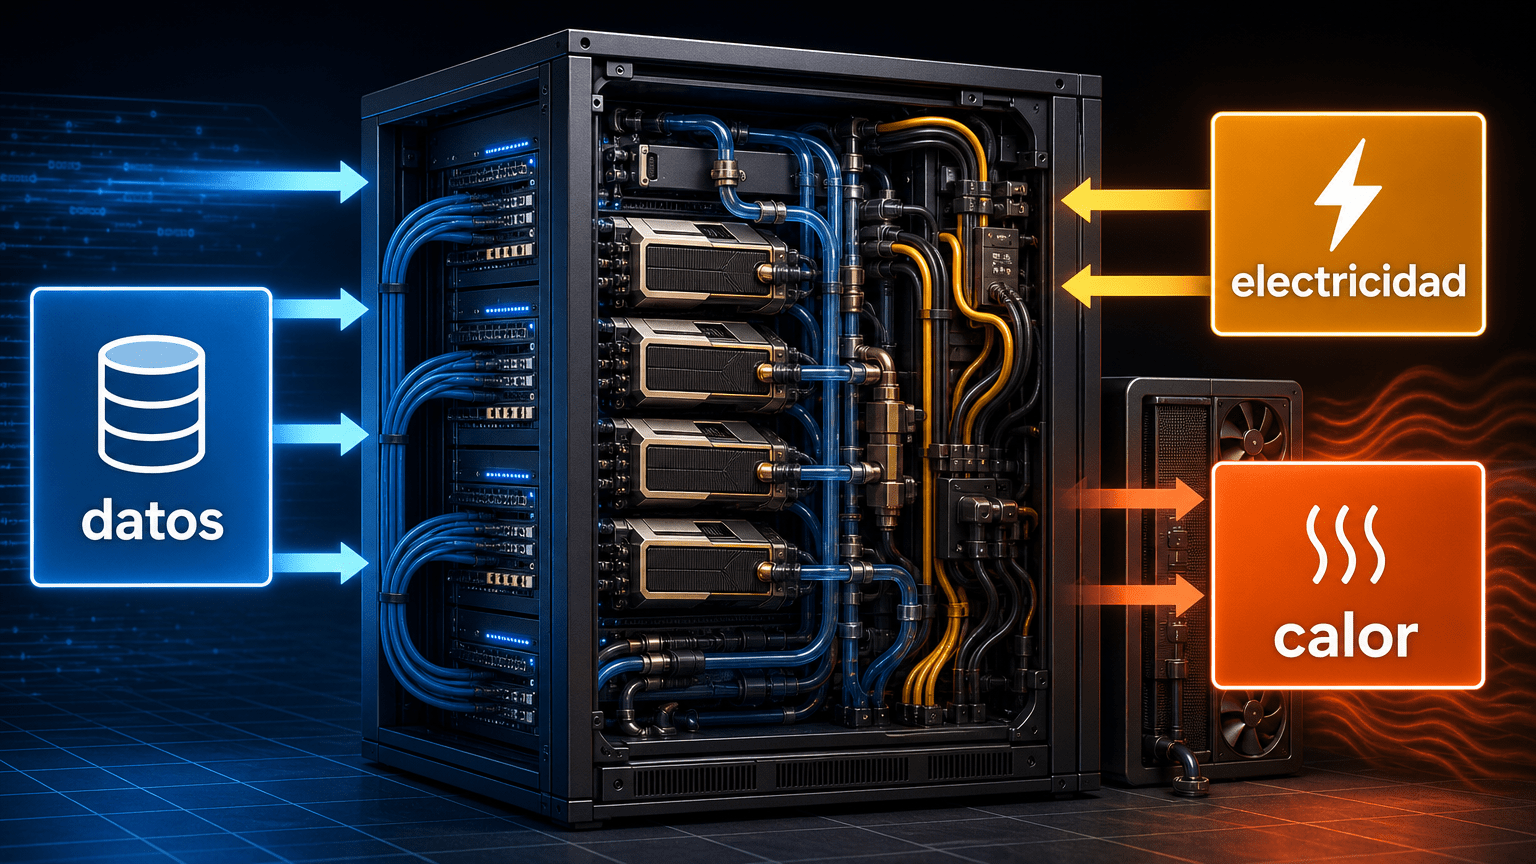
Cientos de aceleradores concentran mucha potencia en poco espacio, y buena parte acaba convertida en calor. Uptime Institute trata la refrigeración como parte crítica del diseño de un centro de datos. La refrigeración líquida ayuda a extraer ese calor, pero exige diseño, fluido, mantenimiento y una distribución eléctrica adecuada.
Además, el coste total no es solo el chip: incluye edificio, red eléctrica, transformadores, permisos, operación y personal. El chip es lo que sale en la foto; el transformador, que nunca posa, suele mandar en el calendario.
La Agencia Internacional de la Energía analiza en *Energy and AI* el consumo de los centros de datos y su crecimiento a escala global. Sirve como contexto, no como una predicción exacta aplicable a un proyecto concreto.
Anunciar no es entregar
Que un producto se presente no significa que esté disponible en todas partes mañana. Los pedidos, la capacidad de fundición, el empaquetado de HBM, las pruebas, la logística y la fabricación de servidores condicionan las entregas. Entre la presentación en el escenario y el rack encendido hay un trecho que las diapositivas no suelen enseñar.
Tampoco damos precios, porque no los hemos comprobado, ni esto es una recomendación financiera: es una explicación de cómo funciona la infraestructura.
Qué conviene recordar
Como hechos: Nvidia combina hardware, software y sistemas, y depende de fundiciones, memoria y empaquetado de terceros. Como anuncios: las cifras de Blackwell, GB200 y GB300 vienen del fabricante y de configuraciones concretas. Como visión de futuro: las «fábricas de IA» son una idea de infraestructura que dependerá de electricidad, refrigeración y suministro.
Cuando leas un titular sobre un nuevo chip, pregúntate tres cosas: quién da la cifra, en qué configuración se midió y cuándo y dónde estará disponible de verdad.
La revolución de la IA no descansa sobre un único chip, sino sobre una cadena entera. Y, como todas las cadenas, aguanta lo que aguante su eslabón más débil.
Redacción LedSolEo
Fuentes y para ampliar información
- NVIDIA CUDA
- NVIDIA Blackwell Architecture
- NVIDIA DGX GB200
- NVIDIA Blackwell Ultra AI Factory Platform, nota de prensa del 18 de marzo de 2025
- TSMC, tecnología CoWoS
- Micron, HBM3E
- Uptime Institute, Cooling Systems for Data Centers
- International Energy Agency, Energy and AI